FoundationDB以确定性仿真消除网络熵 倒逼分布式系统先测后建
"Testing Distributed Systems w/ Deterministic Simulation" by Will Wilson — Strange Loop Conference

Strange Loop Conference

分布式系统的根本缺陷在于不受控的外部熵,唯有在单线程中以伪随机全面模拟硬件与时间,才能在客户遇到严重Bug之前以数倍速率穷尽极端故障空间。

AI-assisted summary of "Testing Distributed Systems w/ Deterministic Simulation" by Will Wilson — original source. Check the original for full context.

Source published:

Key ideas

  • FoundationDB 采取逆向开发哲学,在真正编写数据库之前先耗费数年打造全确定性仿真系统,在单一物理进程内模拟整个分布式集群及磁盘与网络交互,以此攻克分布式系统不可复现的调试难题。 (4:03)
  • 为了在 C++ 中避免多线程带来的非确定性熵,团队自研了 Flow 语言扩展,将高层 Actor 异步语法在编译期重写为纯单线程、回调驱动的状态机执行引擎。 (7:16)
  • 测试框架通过虚拟时间加速、Bugification 变异机制以及赫斯特指数(Hurst exponent)建模多节点级联故障,每晚跑 500 万至 1000 万次模拟,累计完成相当于真实世界数万亿 CPU 小时的测试。 (24:52)
  • 为弥补纯软件模拟对底层硬件与 OS 契约的盲区,团队搭建了由可编程网络电源通宵高频断电的物理集群 Sinkhole;其自身代码未测出缺陷,却抓出了 ZooKeeper 的掉电安全性 Bug 并促使团队彻底自研 Paxos。 (30:37)

Detailed notes

## Background 该视频由 Strange Loop Conference 官方频道于 2014 年 9 月 20 日在 YouTube 发布,主讲人为来自 FoundationDB 的 Will Wilson。根据页面简介,该演讲探讨了在充满网络噪音的环境中调试高度并发分布式系统的极端困境,并详细介绍了通过确定性仿真(Deterministic Simulation)替代物理硬件与网络以实现精确复现缺陷、验证修复方案的工程实践与设计权衡。

## TL;DR Will Wilson 深入剖析了分布式系统因不受控的网络与时序随机性而极难调试的根本痛点,并分享了 FoundationDB 在尚未编写正式数据库前先耗时数年打造确定性仿真框架的逆向研发哲学。为了在单线程中兼顾并发表达力与完全确定性,团队自研了基于 Actor 模型的 C++ 扩展语言 Flow,将网络、磁盘及环境状态全部收拢至伪随机数种子控制之下。通过环形事务不变量、网络阻塞交织(Swizzling)、代码变异(Bugification)以及基于赫斯特指数的重尾级联故障建模,测试框架能以数十万倍于现实的时速挖掘极端并发缺陷。尽管仿真导致传统单步断点调试失效并拉长了日常研发反馈闭环,团队仍辅以物理混沌测试集群 Sinkhole 校验真实掉电边界,最终建立起一套具备全知控制力的高可靠分布式系统工程方法论。

## Atmosphere & style 整场演讲充满硅谷硬核系统黑客式的自嘲幽默与极度理性的技术坦诚,开篇便将排查分布式 Bug 戏谑为“拿叉子扎眼睛”。Will Wilson 的表达兼具严密的数学哲学思辨与实战中的痛苦反思,既能引经据典拆解水利工程统计学中的赫斯特指数,又能绘声绘色地吐槽在机房里连续烧毁上百个 PDU 电源的狼狈遭遇。现场氛围在揭秘极端故障注入的狂放构想与坦承单步调试报废的无奈妥协之间自然流转,让听众在阵阵欢笑中切身感受到顶尖分布式数据库团队对抗物理世界混乱熵增的敬畏与执着。

## Bulletin - [04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) FoundationDB 采取逆向开发哲学,在真正编写数据库之前先耗费数年打造全确定性仿真系统,在单一物理进程内模拟整个分布式集群及磁盘与网络交互,以此攻克分布式系统不可复现的调试难题。 - [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 为了在 C++ 中避免多线程带来的非确定性熵,团队自研了 Flow 语言扩展,将高层 Actor 异步语法在编译期重写为纯单线程、回调驱动的状态机执行引擎。 - [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 测试框架通过虚拟时间加速、Bugification 变异机制以及赫斯特指数(Hurst exponent)建模多节点级联故障,每晚跑 500 万至 1000 万次模拟,累计完成相当于真实世界数万亿 CPU 小时的测试。 - [30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 为弥补纯软件模拟对底层硬件与 OS 契约的盲区,团队搭建了由可编程网络电源通宵高频断电的物理集群 Sinkhole;其自身代码未测出缺陷,却抓出了 ZooKeeper 的掉电安全性 Bug 并促使团队彻底自研 Paxos。

## Key takeaways - [00:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1s) 分布式系统调试困难的深层根源并非单纯的业务复杂性,而是未受控的外部物理熵(不可预测的网络时延、丢包和乱序)打破了函数确定性,使时序相关的潜在 Bug 难以在本地复现和验证。 - [04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) FoundationDB 坚持“先写确定性仿真,再写数据库”的开发路线,通过在单个物理进程内模拟大规模虚拟节点与环境交互,在动工构建核心存储引擎前就彻底解决可复现性问题。 - [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 为杜绝多线程操作系统调度引入的非确定性,团队开发了 Flow 语言扩展作为 C++ 的语法超集,将 Actor 模型的高级并发抽象在编译期静态展开为单线程事件循环回调。 - [12:07](https://www.youtube.com/watch?v=4fFDFbi3toc&t=727s) 确定性模拟网络在内存中实现跨平台接口替换,利用显式指定种子的伪随机数生成器(PRNG)模拟延迟、单向静默断开与数据损毁等恶劣故障。 - [13:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=832s) 任何探查系统当前壁钟时间或物理磁盘剩余空间的调用都会破坏确定性;系统通过对 1% 的模拟任务进行全等双跑并比对 PRNG 最终状态来捕获确定性漏洞。 - [16:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=961s) 测试用例通过极简的不变量进行验证,例如在每秒 1000 次事务与网络交织(Swizzle)、断电损耗等混沌注入下运行环形键值测试,只需在测试尾声检查环拓扑即可直接证伪 ACID 特性。 - [20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) 为了抗衡海量客户硬件与不可预测操作带来的故障探索速度,模拟器利用虚拟时间加速跨越静止等待,并将现实中数年一次的硬件故障压缩至每两到三分钟发生一次,大幅提升单 CPU 小时挖 Bug 的密度。 - [23:06](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1386s) 团队使用 Bugification 宏在仿真中对数据包顺序、超时事件等合法行为进行随机变异,迫使代码暴露其隐性假设,防范接口在狭窄的标准实现子集下形成脆弱依赖。 - [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 现实中硬件故障并非独立的随机试验,而是具备重尾特征的帕累托分布;通过调节赫斯特指数(Hurst exponent),模拟系统能精准还原真实世界中高概率发生的级联关联崩溃。 - [28:58](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1738s) 全模拟虽然让断点调试器因跨节点的单线程回调交织而失效,却让基于重放的精细化 printf 战术成为极其高效的调试利器,排查完补丁后可直接通过完全重放验证问题已被修复。 - [30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 为了兜底模拟器对 OS 语义理解偏差或未构造极端硬件故障的盲区,FoundationDB 打造了 Sinkhole 物理硬件集群,通过脚本控制可编程 PDU 高频断电重启服务器与交换机。 - [33:00](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1980s) Sinkhole 物理断电测试揪出了 ZooKeeper 的掉电安全性缺陷以及 apt 安装未 fsync 导致配置丢失的问题,这促使团队彻底剔除第三方依赖,基于 Flow 完全从零自研 Paxos 并将其纳入模拟框架管理。 - [38:18](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2298s) 确定性模拟相比于在生产环境跑 Netflix Chaos Monkey 的核心优势在于拥有“全知全能的上帝视角”,能够在 Paxos 等协议的最脆弱时序窗口实施精准计算后的定向打击。

## Detailed walkthrough ### [00:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1s) 分布式系统调试的真正痛点:不受控的外部熵

Will Wilson 开场幽默地指出,尽管所有人都承认调试分布式系统比“拿叉子扎自己的眼睛”稍微强一点,但两者之间的差距其实出奇地小。人们常常把分布式系统难调试归咎于“系统太复杂”,但复杂性并不是真正致命的根源。为了阐明真相,Will 举了两个极简的反例:

在第一个场景中,右侧服务器向左侧服务器发送一个非幂等(non-idempotent)数据包。左侧服务器存在一个潜在 Bug——它没有检查数据包被接收的次数。然而只要网络正常,这个 Bug 永远处于无症状状态。某天,因为交换机配置错误或路由器发疯将包乱甩,这个包迷失在网络的“时间黑洞”中;右侧服务器随后触发了分布式系统常见且期望的超时重传;紧接着,失踪的第一个数据包突然重新冒出并被接收。由于非幂等且缺乏校验,系统瞬间崩溃、数据丢失。当你满头大汗试图在本地复现时,重新跑一遍系统却表现完美;再跑一次依然正常。因为引发崩溃的底层网络抖动极其短暂罕见,极度依赖毫秒甚至微秒级的时序。这种 Bug 无法在本地重现,却注定会在客户生产环境再次爆发;更折磨人的是,即使你写了一段补丁,你也根本无法验证它是否真正修复了问题。

```mermaid flowchart LR accTitle: 分布式系统中罕见网络时序导致 Bug 爆发的过程 accDescr: 展示非幂等数据包因网络延迟重传后旧包再度出现引发系统崩溃的流程

subgraph Sender["发送端 (Server Right)"] direction TB P1["发送非幂等包 A (初始)"] Retry["触发超时重传包 A2"] end

subgraph Network["不可控网络环境"] direction TB Delay["数据包 A 滞留于时间黑洞"] Reappear["数据包 A 突然延迟送达"] end

subgraph Receiver["接收端 (Server Left,含无校验Bug)"] direction TB ExecRetry["先处理重传包 A2 (系统正常)"] Crash["再接收迟到包 A (状态损坏,系统崩溃)"] end

P1 --> Delay P1 -.->|"超时"| Retry Retry --> ExecRetry Delay --> Reappear Reappear --> Crash ```

在第二个场景中,右侧服务器先后发送数据包 A 和 B。虽然协议契约并没有规定顺序,但程序员写代码时自然而然会写成 `send(A); send(B);`,没有人会在代码里扔硬币决定发包顺序。这导致左侧服务器长期在巧合下工作,潜意识地假定“A 永远在 B 之前到达”。一旦网络发生乱序,B 先到而 A 后到,整个世界再次崩溃。

Will 指出,表象问题是调试缺乏可重复性,而深层问题在于:我们干净、纯粹的函数世界被混乱肮脏的现实宇宙入侵了。系统的执行历史不再是其输入的纯函数,网络成为了一个完全无法控制的随机性来源(熵)。同样的道理不仅存在于网络,把“网络”替换为“线程”或“磁盘”,并发 Bug 的逻辑完全一致。

- 调试难复现的根源:“The real problem is that the messy dirty Universe has intruded on our beautiful pristine land of pure functions right like the execution history of this system is not a pure function of its inputs there's a source of entropy a source of Randomness which you do not control which is the network.” —— Will Wilson - 数据一致性的代价:对于一般的 Web 服务器或缓存,挂了可以轻松地销毁 VM 重启;但用户对底层数据极其敏感,“人们对自己的数据可没有那么豁达”。

---

[04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) 逆向开发哲学:先做确定性仿真,再做真实数据库

FoundationDB 面临的核心挑战在于:他们要做的是一个提供 ACID 强事务保证的分布式数据库。ACID 绝不可能凭空意外产生,做错的方式远比做对的方式多得多;更危险的是,一个系统在常规流程下能跑通,但一旦遭遇意外环境就瞬间崩塌的概率,远大于它在异常下依然保持正确并持续稳定的概率。团队因此得出结论:如果不能彻底解决调试和测试的可重复性难题,根本就不该动手去造数据库。

团队采取的策略堪称疯狂:在最初的整整几年里,FoundationDB 甚至没有碰真正的数据库网络和磁盘交互,而是先研发了一套全确定性的仿真系统(Deterministic Simulation)。在这套仿真环境被调试到无可挑剔、穷尽所有异常之后,团队才加上真正的网络与磁盘通信,将它蜕变为一个真实的生产数据库。

这项工程的疯狂之处在于仿真范围:系统不仅要在单个物理进程内模拟单个节点,而是要在一个物理进程中模拟出一整个由大量相互通信的虚拟进程构成的网络,同时完整模拟这些进程与外部环境(磁盘、操作系统、网络拓扑)的所有交互。

实现这一架构需要克服三大理论与工程挑战:

1. **单线程伪并发(Single-threaded pseudo concurrency)**:系统在概念上必须模拟许多并发事件和它们自以为在进行的网络通信,但绝对不能使用真正的操作系统线程或多进程并发。因为真并发会重新引入线程调度带来的非确定性熵,破坏确定性。 2. **模拟所有外部交互**:所有进程与宇宙打交道的方式(磁盘 I/O、网络传输、时钟等)都必须由软件模拟实现,将环境中的所有随机性都转化为测试框架人为、受控注入的随机性。 3. **被模拟代码本身的确定性**:进程自身的业务逻辑必须是完全确定性的,不能调用未受控的外部系统状态。

- 研发初期的激进决策:“The thing that that the company did was we didn't write a database we started by writing a simulation of a database a totally deterministic simulation and then once we'd exhaustively debugged that we were like okay now we can write a database which is just that plus talking on networks and talking to discs for real.” —— Will Wilson

---

[07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 打破 C++ 回调地狱:Flow 语言扩展的诞生

在攻关“单线程伪并发”时,团队陷入了艰难的技术选型困境。因为确定性要求,多线程方案被彻底排除;协程在当时存在诸多局限;剩下的唯一底层手段只有“事件回调(Callbacks)”。另一方面,为了追求极致的数据库吞吐与低延迟性能,系统必须使用 C++ 编写。

然而,“C++ 加上纯回调函数无异于人间地狱(a nightmarish hellscape)”,代码的可读性和逻辑推理性会彻底粉碎。团队需要的是高级抽象原语,既能让开发者像写顺序代码一样思考并发,又能在底层编译为单线程、纯回调驱动的状态机。

为此,FoundationDB 创造了 **Flow**。Flow 介于库和新语言之间,是 C++ 的语法超集(附带一个目标代码为 C++ 的预处理编译器)。Flow 引入了基于 Actor 模型的并发语法糖,但物理执行完全由单线程调度器和回调支撑。

```mermaid flowchart TD accTitle: Flow 编译与执行模型 accDescr: 展示 Flow 源代码通过预编译生成纯 C++ 回调状态机并在单线程调度器中执行的过程

subgraph FlowSource["Flow 源代码 (.actor.cpp)"] ActorCode["actor 语法糖定义<br/>高层并发逻辑 (wait / future)"] end

subgraph FlowCompiler["Flow 预处理器 / 编译器"] CodeGen["静态分析并展开状态机<br/>生成对应辅助类与回调函数"] end

subgraph OutputCpp["标准 C++ 源码"] direction TB FuncEntry["入口函数: 立即返回 Future&lt;T&gt;"] StateClass["生成的 Actor 状态机类<br/>封装状态参数与单线程回调逻辑"] end

subgraph Execution["单线程执行引擎"] EventLoop["单线程事件循环 (Event Loop) 调度回调"] end

ActorCode --> FlowCompiler FlowCompiler --> CodeGen CodeGen --> FuncEntry CodeGen --> StateClass FuncEntry -.->|"实例化"| StateClass StateClass --> EventLoop ```

Will 现场展示了一个极简的 Flow 示例——一个异步加法器(Asynchronous Adder):

```cpp ACTOR Future<float> asyncAdd(Future<float> f, float b) { float a = wait(f); return a + b; } ```

针对这段代码,Will 指出了两个初看极不寻常的特征: 1. **非标准关键字 `ACTOR`**:这并非标准 C++,直接传给标准编译器会报错。它向 Flow 编译器标明这是一个需要被展开为 Actor 状态机的函数定义。 2. **表面上的“类型不匹配”**:签名声明返回 `Future<float>`,但函数体内部却直接写了 `return a + b;`(一个普通的 `float`)。这是因为该函数体并不是最终运行的代码,而是一种声明式描述。Flow 编译器会将其重写为一个崭新的外部函数和一个内部状态机类;当调用 `asyncAdd` 时,外部函数会立刻返回一个 `Future<float>`,该 Future 会在整个异步等待链条执行完成、求值结束的一瞬间就绪(Ready)。

在底层展开的代码中,Flow 会重写原函数,给输入参数加上 `const` 修饰符,并将参数打包传入自动生成的内部状态机类构造函数中,以单线程事件回调的机制完成异步驱动。

- 对底层回调方案的评价:“Callbacks plus C++ is like a nightmarish hellscape.” —— Will Wilson

[09:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=582s) Flow 编译器实现与基准测试的局限

Will Wilson 详细解释了 Flow 编译器在幕后所做的工作。当一段 Actor 代码被编译时,编译器会完全自动生成一个 C++ 类,且该类的调用会立即返回。Actor 的主体逻辑被拆解并分散在该类的多个方法中:每当遇到等待异步操作结束的 `wait` 语句时,当前方法就会在此处终止,并在对应的 Future 上设置一个回调函数。该回调函数直接指向 Actor 的下一个逻辑片段。随后,它会立即向一个中央调度器(centralized scheduler)让出控制权(yield),以便程序的其他部分能够继续推进。当整个 Actor 的生命周期走到尽头时,它会利用手中持有的 Promise 去履行(fulfill)最开始对外暴露的那个 Future,最后执行对象的自我清理和销毁。

这种设计的优势在于,程序员可以采用完全直观的 Actor 语法编写逻辑,而所有操作都在单线程中执行,同时保持极高的异步并发性与运行效率。

```mermaid flowchart TD accTitle: Flow 编译与回调流转图 accDescr: 展示 Flow 编译器如何将 Actor 方法拆分并通过中央调度器在单线程中执行异步流转

subgraph Compiler["Flow 编译与生成"] A["Actor 源代码"] -->|"编译生成"| B["C++ 包装类"] B -->|"初始化并立即返回"| C["Future / Promise 对"] end

subgraph Runtime["单线程调度执行"] D["Actor 第一段方法"] -->|"遇到 wait"| E["在 Future 上注册回调"] E -->|"Yield 让出执行权"| F["中央调度器"] F -->|"触发回调"| G["Actor 后续方法"] G -->|"完成执行"| H["履行 Promise 并销毁自身"] end

C -.-> D ```

Will 随后展示了系统的性能数据,但他坦言大家应当“对其持巨大保留态度”(take with a gigantic grain of salt)。这项测试采用了由前一位演讲者 Joe Armstrong 发明的“环形基准测试”(Ring Benchmark):创建 $N$ 个 Actor 排成一个闭合环,在它们之间依次传递消息并循环 $M$ 次。关于为何不应盲目相信这些对比数据,Will 幽默地环顾会场并解释了两点:

> “希望 Joe Armstrong 不在这里,这其实算是一个挺傻的基准测试。” —— Will Wilson

首先,除 Flow 之外的其他测试数据均来自网络上其他人针对各自系统运行的公开结果,虽然假设对方已经尽力优化,但实际运行环境无法考证;其次,环形测试过于简陋,根本无法真实反映分布式 Actor 系统的实际负载。在实践中,当 Actor 内部逻辑越来越复杂、引入更多异步调用时,Flow 的相对性能优势会出现大幅下降。这也是团队着手开发 Flow 2 的主要动力,希望藉此进一步压榨运行效率。

- 环形基准测试逻辑:$N$ 个 Actor 组成环形链路,消息在节点间顺次传递,总共循环传递 $M$ 次。 - 架构现实差异:简单的基准测试无法模拟现实中 Actor 高度异步与复杂状态变更的场景。

---

[12:07](https://www.youtube.com/watch?v=4fFDFbi3toc&t=727s) 确定性模拟的构件:网络抽象与随机故障注入

脱离了定制语言编译器后,Will 转向构建确定性模拟框架的核心要素。由于 FoundationDB 在设计之初就是一个跨平台系统,底层与磁盘、网络等硬件交互的接口早已抽象完毕。因此,团队不需要重构系统,只需在原有的 Unix 网络实现与 Windows 网络实现之外,再平行插入一套“模拟网络”(simulated network)代码。

在模拟网络环境下,建立网络连接不会产生实际的套接字调用,而是实例化一个维护内部状态和缓冲区的 C++ 类。当节点发送数据时,该类会在发送端插入延迟模拟传输耗时,随后在接收端模拟排队延迟,再完成字节的内存拷贝,最后通知接收端有数据可读。

在模拟的 `read` 方法中,团队埋入了一个名为 `roll random cloth` 的故障注入机制,用来逼出潜在的代码缺陷。每次尝试从模拟网络读取数据时,系统都会抛掷随机数。如果遭遇“倒霉”的随机结果,系统会继续连环掷骰子触发各种恶劣场景:或是对端直接挂断,或是本端主动断开,亦或是连接发生未知错误并向读取者抛出异常。Will 直言:

> “通过这种机制,我们试图排查系统里所有假设网络是完全可靠的代码,而做这种假设是一件非常愚蠢的事。” —— Will Wilson

- 跨平台抽象:利用现成的平台接口分离层,无缝接入模拟驱动。 - 模拟网络机制:纯内存缓冲区实现,精准模拟发送侧延迟、接收侧延迟以及数据搬运。 - 故障注入类型:随机连接中断、单向静默断开、底层读取错误等非确定性网络事故。

---

[13:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=832s) 确定性的达成:伪随机控制与 1% 重复运行检验

要实现整套模拟框架,最后一道也是最具挑战性的关卡是“确定性”(determinism)。表面上看,让程序具备确定性似乎理所当然,因为开发者通常不会故意编写非确定性的代码,但这种隐患在日常工程中无处不在。最普遍的例子是随机数——例如指数退避(exponential backoff)算法中使用的随机抖动。若要保证确定性,必须确保系统内所有随机数都源自一个开发者完全可控、显式指定种子的伪随机数生成器(PRNG),而该种子本身则作为整个测试程序的初始输入参数。

更为隐蔽的陷阱存在于系统对环境状态的嗅探中。代码中如果出现类似“在 `if` 条件中检查系统当前时间”或者“查询当前磁盘剩余空间”的操作,确定性就会瞬间被粉碎;即使两次运行的输入完全一致,系统的执行轨迹也会彻底分道扬镳。Will 强调,尽管团队内的工程师都接受过严格训练以识别并规避这些代码习惯,但在庞大的工程中依然会屡屡失手。

为了捕获确定性破坏(determinism failure),FoundationDB 引入了一道防线:在所有模拟测试中,抽取大约 1% 的测试任务执行两次。这两次运行输入完全相同的种子和外部事件序列。在运行结束的最后一刻,系统会去比对伪随机数生成器预备生成的“下一个随机数”。如果两个副本输出的值不完全匹配,就证明两次执行在某个中间步骤的分支判断上产生了分歧,进而触发确定性告警并由开发人员追踪定位。虽然这无法穷尽所有确定性漏洞,但确保了违背确定性的逻辑能在早期被揪出。

- 时间与环境非确定性:禁止读取真实的壁钟时间(wall-clock time)、实时磁盘容量或操作系统硬件计数器。 - 种子驱动:将所有非确定性源头收拢至单一 PRNG 种子,使其构成可重放的程序输入。 - 1% 双跑校验机制:在完全相同的参数下跑两遍,运行结束时校验内部 PRNG 状态是否一致。

---

[16:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=961s) 测试用例编排:环形事务不变量与混沌故障场景

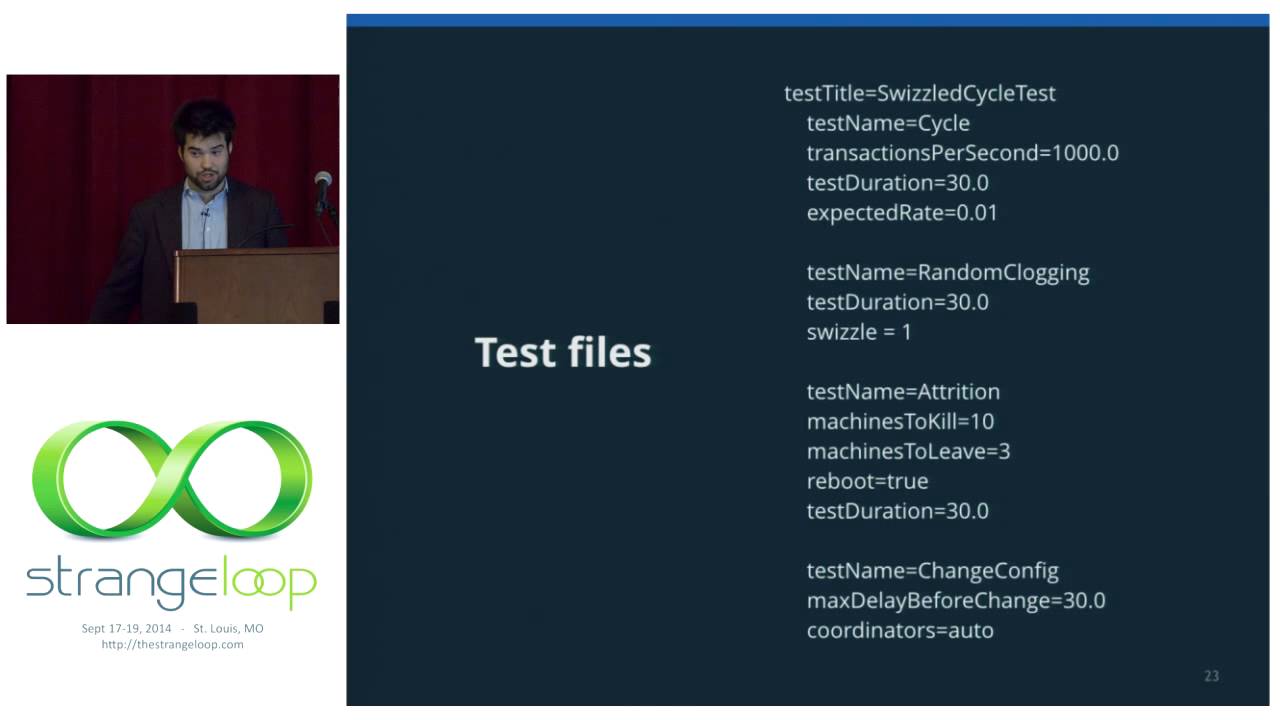
当 Actor 运行时、模拟网络与确定性环境三者合一后,系统就获得了在纯软件环境中完全确定性地模拟整个分布式集群交互的能力。团队通过声明式测试文件来挖掘 Bug。一份测试文件核心包含两类要素:系统要达成的目标(负载),以及试图阻止系统达成目标的各类干扰(故障注入)。

在负载方面,测试声明了一个“环形测试”(cycle test)。系统首先在数据库中写入一个闭环的键值对链表(例如 Value 1 指向 Key 2,以此类推),然后以每秒 1000 个事务的并发速率施加负载。每个并发事务都会对数据库中的键值进行修改,但受制于一个全局约束——事务在整体逻辑上必须保持环的完整性,允许改变节点顺序或位置,但链环不能断裂。

```mermaid flowchart LR accTitle: 环形测试不变量校验逻辑 accDescr: 展示环形键值链路在受到并发事务突变并经历故障注入后,最终通过链环完好性验证 ACID 的过程

A["K1 -> V1 (指向 K2)"] --> B["K2 -> V2 (指向 K3)"] B --> C["K3 -> V3 (指向 K1)"]

subgraph Transactions["并发事务变异 (1000 TPS)"] T["原子性 / 隔离性突变"] end

A -.-> T B -.-> T C -.-> T

T -->|"保持环结构"| PASS["验证通过: ACID 未被破坏"] T -->|"断环 / 伸长 / 缩短"| FAIL["报错: 出现原子性破损或隔离级别冲突"] ```

这一设计的精妙之处在于提供了一个极易验证的不变量(invariant):如果在测试结束后环发生断裂、变长或变短,就直接证明 ACID 遭到了破坏——要么是事务部分写入导致原子性(Atomicity)破损,要么是事务并发覆盖破坏了隔离性(Isolation)。在这个测试中,由于后续施加了极度严苛的故障注入,团队甚至只预期能成功提交 1% 的事务。

而测试文件中用于破坏系统达成目标的干扰手段则极为残暴,主要包含三类: 1. **随机阻塞(Clogging)与交织(Swizzling)**:系统会伪随机且确定性地阻断部分模拟网络连接,使数据包无法收发。测试中启用了名为“Swizzle”的增强模式。Will 承认:

> “交织(Swizzling)基本上可以看作是阻塞(Clogging)的升级版。它会选取一部分网络连接按滚动方式截断,随后以相反的顺序恢复它们;尽管我们完全不理解背后的深层原因,但它在挖 Bug 方面就是比普通阻塞有效得多,这其实挺让人害怕的。” —— Will Wilson

2. **硬件损耗(Attrition)**:在整个 30 秒的测试周期内,系统会随机切断机器电源并在后续恢复,期间总计杀死 10 台机器,任何时刻仅保留 3 台处于开机状态,借此检验集群在极端断电场景下的安全性。 3. **协同变更(Coordination Change)**:这是整个配置中最具破坏性的操作。系统会在混乱流水线中动态触发数据库配置变更,强迫集群在面临网络链路被大面积交错切断、机器接二连三断电重启的极端恶劣环境下,强行执行 Multi-Paxos 共识协议来完成协调节点的交接。

- 环形不变量设计:通过简单的环拓扑检查,无需复杂的外部比对即可在测试尾声直接证伪 ACID 特性。 - 事务预期:在严重干扰下,即便 99% 的事务失败或回滚,只要通过的 1% 满足一致性即算系统正确。 - 复合故障场景:网络阻塞颠倒(Swizzle)、大规模断电重启(Attrition)与一致性协议迁移(Multi-Paxos reconfiguration)在毫秒级时序内并发交织。

[19:11](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1151s) 模拟极端故障场景与“愚蠢系统管理员”

在每秒处理上千次事务的高并发压力下,FoundationDB 的仿真框架正在不断寻找 Paxos 协议实现中的潜在漏洞。Will Wilson 提到,系统所做的测试远不止常规的断网或关机,他们还会注入极其恶劣的渐进式故障。例如,仿真环境会把某些机器置于一种“缓慢死亡”的状态——所有后续系统调用(system calls)都有大约 1% 的概率返回错误。通过这种方式,测试团队可以验证集群是否足够智能,能否及时检测出异常节点、对其进行隔离并在其影响扩散到整个集群之前将其销毁,同时也以此检验系统的优雅停机(graceful shutdown)等特性。

此外,FoundationDB 本身具备“位置感知”(locality)的概念,能够识别机架拓扑结构以及广域网(WAN)链路的位置,而仿真环境完全继承并理解这些信息。这让团队可以轻松模拟“瞬间摧毁整座数据中心”的灾难级场景,以检验数据是否真正具备持久性和高可用性。Will Wilson 还幽默地表示,他们还会模拟现实中“绝不可能存在”的“愚蠢系统管理员”(dumb sysadmins):

> “Like one of the most fun parts of my job is thinking up new and creative ways of torturing our database and then implementing that in simulation.”(我工作中最有趣的部分之一,就是想出各种新颖且极具创意的方法来折磨我们的数据库,然后在仿真中实现它们。)

在这些模拟管理员失误的场景中,仿真框架能够: - 瞬间原子性地互换两台物理机器的 IP 地址,观察集群路由和连接状态如何应对。 - 瞬间将两台计算机上的数据文件互相拷贝覆盖,或者直接在两者之间对换硬盘,检验这种混乱操作是否会导致数据损坏或丢失。

---

[20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) 核心挑战:如何比客户更快地遍历状态空间?

尽管仿真框架极其强大,但确定性仿真测试面临一个本质上的严峻挑战:测试实验室中的计算资源是有限的,测试机群在努力探索所有可能输入与故障模式组成的状态空间;与此同时,真实世界中的客户也在探索同样的空间。Will Wilson 形象地描述了客户的运行环境——他们往往在充满 Bug、容易崩溃、严重超配/欠配(underprovisioned)且配置完全错误的硬件上运行分布式系统,并且在上面执行各种匪夷所思的疯狂操作。最关键的是,一旦系统出现问题,“顺便说一句,如果系统坏了,那就是你的错”。

由于客户的数量及其拥有的机器规模通常比研发实验室多出数个数量级,开发者面临的核心命题是:**如何确保自己在测试环境中遍历错误空间的速度,远快于真实客户遇到这些错误的速度?**

> “Another way of thinking about this is you need to find more bugs per CPU hour than the real world by many orders of magnitude, which is hard.”(换个角度来想,你必须比现实世界每 CPU 小时多发现数个数量级的 Bug,这极其困难。)

```mermaid flowchart TD accTitle: 仿真测试与生产环境探索故障空间的对比 accDescr: 比较测试实验室有限资源与生产环境海量客户硬件在探索故障空间上的差异

subgraph LAB["研发测试实验室"] L_MACH["有限的测试集群"] --> L_EXPLORE["确定性仿真探索"] L_EXPLORE --> L_GOAL["目标:提升每 CPU 小时发现 Bug 概率"] end

subgraph PROD["生产真实世界"] C_USERS["海量客户群体"] --> C_HARDWARE["错误/欠配/配置混乱的硬件"] C_HARDWARE --> C_CHAOS["执行极端、不可预测的操作"] C_CHAOS --> C_EXPLORE["极速遍历故障空间"] end

L_GOAL -.->|"必须大幅领先以提前捕获 Bug"| C_EXPLORE ```

为了战胜客户环境在规模上的压倒性优势,FoundationDB 采用了多种提升 Bug 触发密度的工程策略: - **大幅提高故障频率**:现实世界中,重负载下的硬盘可能两到三年才损坏一次;而在仿真中,系统让硬盘每两到三分钟就损坏一次。这意味着测试环境单位 CPU 小时内经历的磁盘故障数量比真实世界高出几个数量级,从而能更快暴露磁盘故障处理代码中的缺陷。 - **虚拟时间加速(Speed up time)**:分布式集群在许多时候处于静止等待状态,或者在从故障中恢复时需要等待固定的硬编码超时秒数。在单核计算性能允许的情况下,仿真引擎会直接快进虚拟时钟,让一秒真实时间内流逝大量的“仿真秒”,极大压缩无效等待时间。

---

[23:06](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1386s) 变异测试技术:Bugification

除了加快时钟和提升硬件故障率,FoundationDB 采用的另一项关键技术是团队内部称为 **“Bugification”**(Bug 化)的机制。Will Wilson 回顾了早先提到的案例:许多分布式 Bug 属于“无症状 Bug”,即两端代码在契约理解上从一开始就存在分歧,但必须等待某种极其罕见的物理条件才会显现。为了不必被动等待极端罕见的极端事件发生,团队打破了“程序员从不故意改变代码逻辑”的常规,在仿真中主动对代码行为注入随机变异。

`bugif` 本质上是一个宏定义,其工作逻辑是:当系统处于仿真运行状态时,以一个很小的随机概率触发非标准行为(内部结合行号哈希等机制)。通过这种手段,系统可以强制接口暴露出更多潜在合法的边缘行为,防止组件之间的依赖建立在“某个狭窄的常规实现子集”之上。

代码变异的典型应用场景包括: - **颠倒数据包发送顺序**:若常规逻辑是依次发送数据包 A 和数据包 B,宏判定命中后会写成 `if (bugif) { send(B); send(A); }`,以验证接收方是否严格遵循乱序到达的协议规范,而非暗中假设了先后顺序。 - **不完全发送**:在某次网络写入就绪时,故意保留一部分数据不发,仅发送缓冲区中的片段。 - **永久丢弃超时事件**:在判定为 Bugification 运行时,完全抑制超时信号的发送,检验对端是否错误地将超时作为必须到达的控制流依赖。

---

[24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 赫斯特指数与级联故障建模

Will Wilson 引入了他极为热衷的一个数学与工程概念——**赫斯特指数(Hurst exponent)**。该概念最早发表于 1951 年《美国土木工程师学会会刊》(*Transactions of the American Society of Civil Engineers*)中由 Harold Edwin Hurst 撰写的论文《水库的长期蓄水能力》(*Long-term storage capacity of reservoirs*)。作为一名被派往埃及研究尼罗河大坝与水库的英国公职人员,Hurst 发现上一代工程师的设计原则表面上看起来很合理:水库的设计指标是足以抵御“百年一遇的洪水”与“百年一遇的干旱”。然而在实际运行中,这种所谓的“百年一遇”灾害大约每 15 年就会发生一次。

问题根源在于,早期的工程师(以及 2008 年金融危机前的许多金融从业者)错误地假设每天“下雨”或“不下雨”是完全独立的随机试验,事件之间互不相关。但在现实中,若周二下雨,周三下雨的概率显然高于普通基准概率——事件绝非相互独立。高斯正态分布基于独立试验假设,其尾部衰减极快;而赫斯特指数正是用来量化这种“非独立性”的工具。当赫斯特指数大于 0.5 时,系统服从具有“重尾”(heavy tails)特征的稳定帕累托分布(stable Paretian distributions,其参数 $\alpha$ 正好是赫斯特指数的倒数,高斯分布对应 $\alpha=2$ 且赫斯特指数为 0.5)。重尾分布意味着现实中遭遇极高 $\sigma$(标准差)极端事件的概率,远超朴素正态分布的预期。

> “The answer is hardware failures are not independent random events. Okay? You all know this in your guts, right? Like if a hard drive fails in a rack, what is the first thing you do? Oh my god, check every other hard drive in that rack!”(答案是:硬件故障并不是独立的随机事件。大家打心底里都知道这一点,对吧?比如机架里有一块硬盘坏了,你的第一反应是什么?天哪,赶紧检查那个机架上的所有其他硬盘!)

一块硬盘故障,可能意味着整批硬件质量有瑕疵、机房维护操作不当或者数据中心湿度异常。多节点级联故障在统计学上极为常见,但在物理硬件测试中极难复现与构造。而在确定性仿真环境中,FoundationDB 可以自由调节赫斯特指数,人为制造大量高密度的多节点级联关联崩溃,以此测试系统在真实极端环境下的生存韧性。

- **庞大的测试规模**:结合时间加速、故障注入与 Bugification,FoundationDB 估算他们已经执行了相当于真实世界**数万亿 CPU 小时**的测试。 - **日常回归吞吐量**:利用测试集群,团队每晚运行 **500 万到 1000 万次** 独立的仿真测试。 - **场景跨度**:每次仿真测试模拟整个分布式集群在 5 分钟到 1 到 2 个小时内的完整运作过程,该机制已稳定运行多年。

---

[28:58](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1738s) 仿真带来的代价:回调地狱与调试灾难

在确定性仿真带来巨大测试收益的同时,Will Wilson 话锋一转,指出这也带来了一个极其棘手的负面代价:“我们彻底毁掉了调试”(we've totally broken debugging)。

在传统的异步编程模型中,代码中往往充斥着层层嵌套的事件回调函数(callbacks),在单机环境下单步调试这种代码本就极其痛苦。如果在一个完全由事件驱动、内部全由回调交织而成的确定性仿真系统里,用传统断点调试器去排查由多个“充斥着回调的怪物节点”组成的分布式死锁或状态错误,其复杂度与认知负荷将呈指数级爆炸。常规单步调试工具面对这种高度交织的事件仿真基本处于失效状态,必须寻求全新的架构与语言层支持来解决这一困局。

[29:25](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1765s) 调试困境与基于确定性模拟的“printf 战术”

当所有节点与模拟器逻辑全都塞进同一个进程时,传统的交互式调试变得极其反人类。不仅有多个相互协作的节点在同一个挂载的进程里共存,外层还包裹着整套竭力欺骗节点“它们正通过网络向彼此通信”的模拟框架代码。在调用栈里逐帧单步跟踪极为艰难,Will Wilson 坦言团队里虽然有两三位神级工程师能硬生生在栈里向下深潜两三层单步单步排查并让全组叹为观止,但对其余普通工程师而言根本不可行。

最终剩下的调试利器退化到了看似最原始的手段——打日志(printf)。Will Wilson 直白地承认:

> “So what you're left with is basically printf, which sounds pretty horrible and barbaric, and I'll be honest it is, but it's actually not that bad when you have deterministic simulation.”

在具备确定性模拟的前提下,printf 的威力被彻底释放。只要用完全相同的输入重新跑模拟,所有事情就会在完全相同的时刻、以完全相同的顺序发生。工程师不需要打印海量垃圾日志,而是可以针对“已知下次必定触发”的精确前置条件添加针对性日志,一层层将 printf 推进到代码深处,像步步紧逼一样把 Bug 逼入死角并彻底剿灭。修完之后再次回放,还能立即验证 Bug 是否真的不再重现。

---

[30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 模拟框架的盲区与残酷的物理集群 “Sinkhole”

确定性模拟虽然强大,但依然存在一种终极噩梦:模拟本身是错误的。这通常来自两个方向: 1. **残酷程度不够**:现实世界中存在某种极其诡异的网络或硬件故障模式,但模拟器从未构造过这种模式。 2. **对操作系统契约理解有误或 OS 本身有 Bug**:比如团队自以为理解了 `fsync` 的语义,但实际行为存在出入;或者跨平台移植时,同名系统调用在不同 OS 上的底层保证存在微妙差异。

为了捕获这类超出模拟器认知的真实漏洞,FoundationDB 打造了一个专门的后备物理测试集群——**Sinkhole**。该集群由多块配备 ECC 内存的小型服务器主板组成,彼此通过五类线(CAT 5)和交换机互联。最致命的设计在于:交换机和所有主板全部插在可编程网络电源(PDU)上,由脚本控制整夜对整套集群疯狂切断和恢复电源。

```mermaid flowchart TD accTitle: Sinkhole 物理混沌测试集群架构 accDescr: 展示可编程电源控制主板与交换机断电重启以测试掉电安全性的硬件拓扑架构

subgraph PowerCtrl["自动化控制层"] PDU["可编程网络电源<br/>(PDU / 脚本轮流断电)"] end

subgraph HardwareCluster["Sinkhole 硬件环境"] SW["网络交换机<br/>(模拟物理网络断联)"] MB1["真实服务器主板 1<br/>(ECC RAM + SSD)"] MB2["真实服务器主板 2<br/>(ECC RAM + SSD)"] MB3["真实服务器主板 3<br/>(ECC RAM + SSD)"] end

subgraph StackUnderPower["被测对象"] FDB["FoundationDB 数据库进程<br/>(验证掉电安全性)"] end

PDU -.->|"高频断电 / 烧毁风险"| SW PDU -.->|"高频断电 / 极损 SSD"| MB1 PDU -.->|"高频断电 / 极损 SSD"| MB2 PDU -.->|"高频断电 / 极损 SSD"| MB3 SW --- MB1 SW --- MB2 SW --- MB3 MB1 & MB2 & MB3 --- FDB ```

尽管硬件损耗极其惨烈——市面上的可编程电源质量堪忧,连续开关两天就会报废烧毁,团队为此用坏了上百个电源,高速断电对 SSD 也是极具破坏性的损耗——但在 FoundationDB 数据库自身的代码上,Sinkhole 从未炸出过任何 Bug。这反向证明了模拟器在覆盖系统边界上做得相当出色。

- **硬件配置**:小型真实服务器主板、ECC 内存、千兆网线与交换机,全部由可编程网络 PDU 供电。 - **运行方式**:数据库跑负载的同时,全自动脚本通宵交替切断/接通主板与交换机电源。 - **硬件战损**:网络可编程电源几天就烧掉一批,损耗了上百台;SSD 在高频掉电下故障率极高。 - **测试战果**:在 FoundationDB 自身代码中从未发现过掉电安全 Bug。

---

[33:00](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1980s) 第三方依赖的惨痛教训:弃用 ZooKeeper 与 APT 的“fsync 惨案”

尽管自身代码抗住了掉电考验,但 Sinkhole 却无情揪出了第三方软件的缺陷。非 Flow 语言编写、无法进入确定性模拟的外部代码,构成了系统的致命盲区。

在 FoundationDB 早期版本中,团队曾引入 ZooKeeper 来维护集群协调状态。在 Sinkhole 的早期雏形测试中,他们直接抓到了 ZooKeeper 的一个严重掉电安全性 Bug。虽然上报后 Apache 官方修复了该问题,但这段惊魂经历让团队彻底丧失了对外部依赖的安全感。Will Wilson 提到,这一创伤促使他们做出激进决定:直接把 ZooKeeper 彻底剥离出技术栈,完全基于 Flow 从零编写了一套自研 Paxos 实现,将其完全置于确定性模拟的保护伞之下;顺带还省去了部署和维护 Java 运行时的巨大麻烦。

另一次荒谬的事故发生在包管理工具上。团队在 Sinkhole 的多台机器上安装数据库并启动运行,接着对集群进行疯狂断电。重启后,其中一个进程竟然无法拉起。排查后发现,底层数据文件由于正确调用了持久化刷盘与日志,完好无损地躺在磁盘上;然而数据库的配置文件却彻底损坏或丢失了。罪魁祸首竟然是 Debian/Ubuntu 的包管理器 `apt` 在写入配置时未调用 `fsync`。进程重启后判定“没有配置文件却有一堆数据文件”,误以为状态错乱而主动 Panic。

---

[34:31](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2071s) 人机关系的异化与打破研发“心流”的十万次模拟

在技术分享的收尾阶段,Will Wilson 探讨了分布式测试在面对天文数字般的故障状态空间时,工程团队面临的深层困惑与未来方向。他幽默地感慨技术开发似乎进入了某种“人机关系的新阶段”:

> “I feel like we've entered like a new phase in the relationship between man and machine, because if you look at the workflow of one of us, it looks like: you make some changes to the program, you recompile, and then you run like 10,000 simulations to see if you did something obviously dumb, and then you hope that if you did something subtly dumb, you'll get caught that night when we run 10 million.”

每次写完几行代码,跑 10,000 次模拟需要等上一两分钟甚至更久。这彻底打破了程序员沉浸式的 Coding 状态(Flow state)。很多人之所以喜欢解释型语言,就是为了省去哪怕几秒钟的编译时间,而 FoundationDB 却把单次调试循环拉长到了数分钟之久。Will Wilson 指出,增加更多硬件资源也许能显著压缩等待时长,从而反常识地大幅拯救工程师的日常生产力。

此外,为了防范模拟器自身的“盲点”引发类似抗药性的现象,团队还构想过以下手段: - **专职 Bug 注入工程师**:雇佣专人向代码库故意植入隐秘 Bug,测试它们能否穿透模拟框架;若能穿透,则视为对模拟器框架本身的 Bug 报告。 - **双重模拟框架**:建立两套原理各异的模拟器。一套用于日常敏捷开发回归,另一套专门在发布前夜运行上千万次模拟测试,杜绝单一模拟器模式下的“抗药性”。 - **加码真实硬件测试**:虽然面对硬件极其痛苦(有同事戏言“编程除了跟网络、磁盘和电源打交道的部分很好玩,其余全都很痛苦”,结果现在整天全在摆弄硬件和被烧毁的电源),但适度增加像 Sinkhole 这样的真实物理混沌注入,依然是弥补纯软件模拟盲区不可或缺的防线。

---

[38:18](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2298s) 现场问答:模拟器对抗 Netflix Chaos Monkey 与确定性的“全知全能”

在演讲后的问答环节,有观众提问:这种测试方式与 Netflix 的混沌工程(Chaos Army / Chaos Monkey)有何不同?是否考虑过直接在生产环境中制造混乱?

Will Wilson 首先重申了架构基础:模拟测试运行的正是纯粹的**生产环境核心代码**,唯一的区别是剥离了真正对接物理磁盘与物理网络的底层系统调用胶水层。在比较确定性模拟与生产环境混沌测试的优劣时,Will Wilson 深刻剖析了模拟测试独有的上帝视角:

> “The benefit of simulation is you can do many, many more different types of things, and you can generally be far more brutal and far more like calculatedly evil. Like in a real production environment, you don't have like omnipotent evil Godlike power to like stop and start network connections in the most inconvenient possible way, or to like do what you know is like the hard case for Paxos and like deliberately do that to try and screw with it.”

在真实生产环境搞破坏,系统无法拥有这种“全知全能的邪恶力量”,去在最刁钻的时间点精准掐断网络,或者专门针对 Paxos 的极限 Corner Case 实施定向破坏。然而真实物理测试的优势在于能发现软件模型未曾预料的硬件异常,生产客户所使用的特定磁盘、网卡也可能存在未知的固件隐患,这恰恰是软件模拟无法感知的。因此两种方案各有千秋,兼收并蓄才是最稳健的体系。会议在对 Hurst 统计学指数相关问题的简短交谈与全场致意中落下帷幕。

## Notable quotes > [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) The answer is hardware failures are not independent random events. Okay? You all know this in your guts, right? Like if a hard drive fails in a rack, what is the first thing you do? Oh my god, check every other hard drive in that rack! — Will Wilson

> [20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) Another way of thinking about this is you need to find more bugs per CPU hour than the real world by many orders of magnitude, which is hard. — Will Wilson

> [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) Callbacks plus C++ is like a nightmarish hellscape. — Will Wilson

## Mentioned Will Wilson, FoundationDB, Flow, Joe Armstrong, Multi-Paxos, Paxos, Harold Edwin Hurst, Sinkhole, Apache ZooKeeper, Debian, Ubuntu, APT, Netflix, Chaos Monkey

## Video description Debugging highly concurrent distributed systems in a noisy network environment is an exceptionally challenging endeavor. On the one hand, evaluating all possible orders in which program events can occur is a task ill-suited to human cognition, rendering a pure analytic understanding of the control flow of such a system beyond the reach of any individual programmer. On the other hand, a more “empirical” approach to the task is also fraught with difficulty, as the dependence of severe bugs on precise timings or transient network conditions makes every part of the debugging cycle – from bug replication to verification of a fix – a Sisyphean labor bordering on the impossible.

One approach which has been developed to ameliorate this situation is that of deterministic simulation, wherein the hardware components of the system – including hard disks, network links, and the machines themselves – are replaced in testing with software which fulfills the contracts of those systems, but whose state is completely transparent to the developer. This enables the simulation of a wide diversity of failure modes including network failures, disk failures or space exhaustion, unexpected machine shutdown or reboot, IP address changes, and even entire datacenter failures. Moreover, once a particular pattern of failures has been identified which uncovers a bug, the determinism property of the simulation means that the exact same series of events can be replayed an indefinite number of times, greatly facilitating the debugging process, and providing confidence when a bug has been fixed.

Attendees of this talk will gain an understanding of the benefits, drawbacks, and tradeoffs involved in implementing a deterministic simulation framework, with frequent reference both to theory and to real-world engineering experience gleaned from applying this method to a complex distributed system. Attendees will also learn about language features which aid in the development of such a framework.

Will Wilson FoundationDB

Will Wilson works on the engineering team at FoundationDB (https://foundationdb.com). Will started his career in biotechnology, leading a successful R&D effort in spinal cord injury diagnostics, currently undergoing commercialization by a company he co-founded. Since then, Will has worked in a variety of technical and business roles at data science and data virtualization startups. Will has a degree in math and philosophy from Yale.

[Source](https://www.youtube.com/watch?v=4fFDFbi3toc)

中文简报

FoundationDB通过单线程集群模拟杜绝数据丢失 除非开发人员消除现实硬件的熵增,并在加速的确定性模拟器中验证生产逻辑,否则分布式系统无法保证事务可靠性。 Will Wilson概述了FoundationDB在实现物理数据库本体之前,先构建一套完全确定性模拟框架的架构抉择,以确保事务的ACID保证能够得到可靠测试。为了消除线程调度的随机性并兼顾C++的高性能,团队构建了Flow——一种基于Actor模型的语言扩展,可将异步例程编译为单线程状态机。通过用确定性模型替换网络与磁盘接口,该引擎能将数年的运行时间压缩至数分钟,注入合成灾难、利用赫斯特指数(Hurst exponent)模拟关联级联故障,并通过“buggify”宏进行随机契约排列。尽管确定性模拟在每晚数百万次运行中极大地加速了缺陷发现,但也迫使工程师依赖确定性的“printf”日志记录,并借助名为“Sinkhole”的专用硬件集群进行补充性的物理混沌测试。 FoundationDB在编写实际数据库引擎前耗费了最初两年构建一套完全确定性的模拟系统,以确保所有并发和网络交互均可在单个操作系统进程内测试。 (4:03) 团队创建了基于Actor模型的C++语法扩展与预编译器Flow,以避免回调地狱,并在没有硬件线程竞态条件的情况下提供确定性、单线程的伪并发。 (7:16) FoundationDB通过加快故障发生频率并跳过模拟的空闲时间,每晚运行500万至1000万次模拟——相当于数万亿小时的现实CPU运行时间。 (28:26) 在名为“Sinkhole”的断电循环集群上进行的物理验证发现了Apache ZooKeeper中的一处断电安全漏洞以及Linux apt包管理器中一处缺失fsync的漏洞,而在FoundationDB自身中未发现任何断电安全漏洞。 (33:02)

精炼阅读摘要

FoundationDB 工程师 Will Wilson 认为,分布式系统难以调试的根源并非单纯的架构复杂度,而是不受控的外部环境熵(如网络、硬件与调度的不确定性)打破了纯函数式的因果规律。为此,团队确立了在编写实际数据库引擎前先构建 100% 确定性模拟器的理念,通过全受控的执行历史彻底解决分布式并发缺陷不可复现的痛点。 环境熵入侵与模拟优先架构 (0:01) 分布式系统在现实中往往因为偶发且短暂的网络抖动(如数据包乱序、重发延时或非幂等处理失误)诱发致命崩溃。由于开发人员在本地重启后无法复现微秒级的临界时序,常规的调试与修复验证极度困难。Wilson 指出,ACID 事务的正确性极其脆弱,错误实现数不胜数且常在正常测试中表现正常,但用户绝不容忍数据丢失。因此,团队在项目前两年完全没有编写物理数据库,而是全力开发了一套能在单个操作系统进程内运行整个分布式集群的确定性模拟系统。该体系立足于三大支柱:单线程伪并发、软件虚拟化的环境通信接口(网络、磁盘、时钟),以及完全确定性的进程内部逻辑。 Flow 语言与单线程伪并发调度 (7:16) 为了在单个操作系统进程中运行数十个虚拟节点并彻底消除多线程硬件调度的非确定性,团队摒弃了常规的多线程与当时尚不成熟的协程方案。然而,直接使用 C++ 编写回调函数会导致代码演变为难以阅读和维护的复杂状态机。为此,FoundationDB 开发了名为 Flow 的语法扩展预编译器。Flow 结合了 Actor 模型与 C++ 的执行效率,工程师可采用类似线性同步调用的语法编写异步逻辑,随后由编译器自动将其转换为基于回调的单线程状态机,并由集中式事件循环统一调度。在针对消息传递延迟的“环形基准测试”(Ring Benchmark)中,Flow 展现了显著的调度效率,但 Wilson 同时也坦承随着 Actor 内部异步逻辑复杂度上升其性能优势会有所稀释,团队因此启动了 Flow 2 的研发以应对扩展挑战。 混沌故障注入与不变量检验 (12:00) 模拟环境中的网络与存储均采用轻量级 C++ 对象替代真实系统调用。在读取网络数据时,系统通过受控的伪随机数生成器(PRNG)调用随机闭包函数,人为制造连接中断、延时或单向丢弃,以强行暴露代码中对网络可靠性的隐式假设。为防止代码偷偷调用真实系统时间或磁盘余量引入不确定性,测试框架会将约 1% 的模拟测试执行两次,并在结束时比对 PRNG 最终状态以核验完全一致。在验证层面,系统引入了对抗性的“循环测试”(Cycle Test):数据库以每秒 1000 笔事务的高并发速率持续修改一组形成闭环的键值对,若 ACID 的原子性或隔离性遭到破坏,闭环结构必然变异,从而实现无需系统崩溃即可自动检出的不变量断言;在此期间,测试框架还会同步施加网络反转阻滞(Swizzle)、节点断电重启以及 Multi-Paxos 动态集群重配等多重压力。 时间压缩、Bugification 与长尾灾难 (20:42) 面对数以万计客户 CPU 年限与有限测试算力之间的巨大差距,模拟框架必须在单位 CPU 工时内爆发式提升故障密度。团队将真实世界中两到三年才发生一次的磁盘物理损坏,压缩至模拟器中每两到三分钟发生一次;遇到节点等待超时的空闲期,模拟时钟会瞬间跳跃,以此在一台物理机上实现超越物理时间的超高密度测试。此外,代码中嵌入了基于行号哈希的 `buggify` 宏,在模拟环境中以极小概率激活非标准但合规的极端边缘逻辑(如刻意抑制超时或反转包序)。Wilson 引用了 Harold Edwin Hurst 于 1951 年在尼罗河水坝研究中提出的赫斯特指数(Hurst Exponent),指出真实世界的物理故障从来不是高斯分布下的独立事件,而是具有强相关性的肥尾分布;通过在模拟中调高该指数,系统能够高效复现成批发生的级联硬件灾难。 物理验证机群与模拟调试的局限 (30:37) 依靠时间跳跃与故障加速,团队每晚可在测试集群上运行 500 万至 1000 万次模拟,累计覆盖了相当于数万亿真实 CPU 工时的执行历程。然而,高度嵌套的回调状态机导致传统 GDB 单步调试彻底失效,开发者转而依赖确定性模拟下输入种子完全一致的特性,通过精准、条件化的 `printf` 逐步缩小排错范围。同时,针对模拟可能误判操作系统底层语义(如跨平台的 `fsync` 契约差异)的短板,团队搭建了名为“Sinkhole”的真实硬件混沌机群,利用可编程电源分配单元对主板和交换机进行彻夜断电测试。尽管烧毁了大量电源插座和固态硬盘,Sinkhole 从未在数据库自身逻辑中检出断电安全性缺陷,反倒逼出了第三方软件的隐患:早期依赖的 ZooKeeper 因断电漏洞被团队彻底移除并重写为纯 Flow 实现的 Paxos,操作系统的软件包管理器(`apt`)也曾因安装缺少 `fsync` 导致配置文件在断电后损坏。 Will Wilson 总结指出,相比于针对实际物理硬件的生产环境混沌工程(如 Chaos Monkey),确定性模拟虽需前期投入数年基建且牺牲了单步调试的人机工效,但它赋予了开发者对并发时序绝对精准的掌控力与百分之百的可复现性。模拟测试的核心瓶颈在于模拟模型本身是否存在盲区,因此结合真实硬件层面的断电混沌测试,是确保全分布式系统达成企业级可靠性的关键闭环。

Detailed notes — zh

## Background 该视频由 Strange Loop Conference 官方频道于 2014 年 9 月 20 日在 YouTube 发布,主讲人为来自 FoundationDB 的 Will Wilson。根据页面简介,该演讲探讨了在充满网络噪音的环境中调试高度并发分布式系统的极端困境,并详细介绍了通过确定性仿真(Deterministic Simulation)替代物理硬件与网络以实现精确复现缺陷、验证修复方案的工程实践与设计权衡。 ## TL;DR Will Wilson 深入剖析了分布式系统因不受控的网络与时序随机性而极难调试的根本痛点,并分享了 FoundationDB 在尚未编写正式数据库前先耗时数年打造确定性仿真框架的逆向研发哲学。为了在单线程中兼顾并发表达力与完全确定性,团队自研了基于 Actor 模型的 C++ 扩展语言 Flow,将网络、磁盘及环境状态全部收拢至伪随机数种子控制之下。通过环形事务不变量、网络阻塞交织(Swizzling)、代码变异(Bugification)以及基于赫斯特指数的重尾级联故障建模,测试框架能以数十万倍于现实的时速挖掘极端并发缺陷。尽管仿真导致传统单步断点调试失效并拉长了日常研发反馈闭环,团队仍辅以物理混沌测试集群 Sinkhole 校验真实掉电边界,最终建立起一套具备全知控制力的高可靠分布式系统工程方法论。 ## Atmosphere & style 整场演讲充满硅谷硬核系统黑客式的自嘲幽默与极度理性的技术坦诚,开篇便将排查分布式 Bug 戏谑为“拿叉子扎眼睛”。Will Wilson 的表达兼具严密的数学哲学思辨与实战中的痛苦反思,既能引经据典拆解水利工程统计学中的赫斯特指数,又能绘声绘色地吐槽在机房里连续烧毁上百个 PDU 电源的狼狈遭遇。现场氛围在揭秘极端故障注入的狂放构想与坦承单步调试报废的无奈妥协之间自然流转,让听众在阵阵欢笑中切身感受到顶尖分布式数据库团队对抗物理世界混乱熵增的敬畏与执着。 ## Bulletin - [04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) FoundationDB 采取逆向开发哲学,在真正编写数据库之前先耗费数年打造全确定性仿真系统,在单一物理进程内模拟整个分布式集群及磁盘与网络交互,以此攻克分布式系统不可复现的调试难题。 - [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 为了在 C++ 中避免多线程带来的非确定性熵,团队自研了 Flow 语言扩展,将高层 Actor 异步语法在编译期重写为纯单线程、回调驱动的状态机执行引擎。 - [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 测试框架通过虚拟时间加速、Bugification 变异机制以及赫斯特指数(Hurst exponent)建模多节点级联故障,每晚跑 500 万至 1000 万次模拟,累计完成相当于真实世界数万亿 CPU 小时的测试。 - [30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 为弥补纯软件模拟对底层硬件与 OS 契约的盲区,团队搭建了由可编程网络电源通宵高频断电的物理集群 Sinkhole;其自身代码未测出缺陷,却抓出了 ZooKeeper 的掉电安全性 Bug 并促使团队彻底自研 Paxos。 ## Key takeaways - [00:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1s) 分布式系统调试困难的深层根源并非单纯的业务复杂性,而是未受控的外部物理熵(不可预测的网络时延、丢包和乱序)打破了函数确定性,使时序相关的潜在 Bug 难以在本地复现和验证。 - [04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) FoundationDB 坚持“先写确定性仿真,再写数据库”的开发路线,通过在单个物理进程内模拟大规模虚拟节点与环境交互,在动工构建核心存储引擎前就彻底解决可复现性问题。 - [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 为杜绝多线程操作系统调度引入的非确定性,团队开发了 Flow 语言扩展作为 C++ 的语法超集,将 Actor 模型的高级并发抽象在编译期静态展开为单线程事件循环回调。 - [12:07](https://www.youtube.com/watch?v=4fFDFbi3toc&t=727s) 确定性模拟网络在内存中实现跨平台接口替换,利用显式指定种子的伪随机数生成器(PRNG)模拟延迟、单向静默断开与数据损毁等恶劣故障。 - [13:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=832s) 任何探查系统当前壁钟时间或物理磁盘剩余空间的调用都会破坏确定性;系统通过对 1% 的模拟任务进行全等双跑并比对 PRNG 最终状态来捕获确定性漏洞。 - [16:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=961s) 测试用例通过极简的不变量进行验证,例如在每秒 1000 次事务与网络交织(Swizzle)、断电损耗等混沌注入下运行环形键值测试,只需在测试尾声检查环拓扑即可直接证伪 ACID 特性。 - [20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) 为了抗衡海量客户硬件与不可预测操作带来的故障探索速度,模拟器利用虚拟时间加速跨越静止等待,并将现实中数年一次的硬件故障压缩至每两到三分钟发生一次,大幅提升单 CPU 小时挖 Bug 的密度。 - [23:06](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1386s) 团队使用 Bugification 宏在仿真中对数据包顺序、超时事件等合法行为进行随机变异,迫使代码暴露其隐性假设,防范接口在狭窄的标准实现子集下形成脆弱依赖。 - [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 现实中硬件故障并非独立的随机试验,而是具备重尾特征的帕累托分布;通过调节赫斯特指数(Hurst exponent),模拟系统能精准还原真实世界中高概率发生的级联关联崩溃。 - [28:58](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1738s) 全模拟虽然让断点调试器因跨节点的单线程回调交织而失效,却让基于重放的精细化 printf 战术成为极其高效的调试利器,排查完补丁后可直接通过完全重放验证问题已被修复。 - [30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 为了兜底模拟器对 OS 语义理解偏差或未构造极端硬件故障的盲区,FoundationDB 打造了 Sinkhole 物理硬件集群,通过脚本控制可编程 PDU 高频断电重启服务器与交换机。 - [33:00](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1980s) Sinkhole 物理断电测试揪出了 ZooKeeper 的掉电安全性缺陷以及 apt 安装未 fsync 导致配置丢失的问题,这促使团队彻底剔除第三方依赖,基于 Flow 完全从零自研 Paxos 并将其纳入模拟框架管理。 - [38:18](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2298s) 确定性模拟相比于在生产环境跑 Netflix Chaos Monkey 的核心优势在于拥有“全知全能的上帝视角”,能够在 Paxos 等协议的最脆弱时序窗口实施精准计算后的定向打击。 ## Detailed walkthrough ### [00:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1s) 分布式系统调试的真正痛点:不受控的外部熵 Will Wilson 开场幽默地指出,尽管所有人都承认调试分布式系统比“拿叉子扎自己的眼睛”稍微强一点,但两者之间的差距其实出奇地小。人们常常把分布式系统难调试归咎于“系统太复杂”,但复杂性并不是真正致命的根源。为了阐明真相,Will 举了两个极简的反例: 在第一个场景中,右侧服务器向左侧服务器发送一个非幂等(non-idempotent)数据包。左侧服务器存在一个潜在 Bug——它没有检查数据包被接收的次数。然而只要网络正常,这个 Bug 永远处于无症状状态。某天,因为交换机配置错误或路由器发疯将包乱甩,这个包迷失在网络的“时间黑洞”中;右侧服务器随后触发了分布式系统常见且期望的超时重传;紧接着,失踪的第一个数据包突然重新冒出并被接收。由于非幂等且缺乏校验,系统瞬间崩溃、数据丢失。当你满头大汗试图在本地复现时,重新跑一遍系统却表现完美;再跑一次依然正常。因为引发崩溃的底层网络抖动极其短暂罕见,极度依赖毫秒甚至微秒级的时序。这种 Bug 无法在本地重现,却注定会在客户生产环境再次爆发;更折磨人的是,即使你写了一段补丁,你也根本无法验证它是否真正修复了问题。 ```mermaid flowchart LR accTitle: 分布式系统中罕见网络时序导致 Bug 爆发的过程 accDescr: 展示非幂等数据包因网络延迟重传后旧包再度出现引发系统崩溃的流程 subgraph Sender["发送端 (Server Right)"] direction TB P1["发送非幂等包 A (初始)"] Retry["触发超时重传包 A2"] end subgraph Network["不可控网络环境"] direction TB Delay["数据包 A 滞留于时间黑洞"] Reappear["数据包 A 突然延迟送达"] end subgraph Receiver["接收端 (Server Left,含无校验Bug)"] direction TB ExecRetry["先处理重传包 A2 (系统正常)"] Crash["再接收迟到包 A (状态损坏,系统崩溃)"] end P1 --> Delay P1 -.->|"超时"| Retry Retry --> ExecRetry Delay --> Reappear Reappear --> Crash ``` 在第二个场景中,右侧服务器先后发送数据包 A 和 B。虽然协议契约并没有规定顺序,但程序员写代码时自然而然会写成 `send(A); send(B);`,没有人会在代码里扔硬币决定发包顺序。这导致左侧服务器长期在巧合下工作,潜意识地假定“A 永远在 B 之前到达”。一旦网络发生乱序,B 先到而 A 后到,整个世界再次崩溃。 Will 指出,表象问题是调试缺乏可重复性,而深层问题在于:我们干净、纯粹的函数世界被混乱肮脏的现实宇宙入侵了。系统的执行历史不再是其输入的纯函数,网络成为了一个完全无法控制的随机性来源(熵)。同样的道理不仅存在于网络,把“网络”替换为“线程”或“磁盘”,并发 Bug 的逻辑完全一致。 - 调试难复现的根源:“The real problem is that the messy dirty Universe has intruded on our beautiful pristine land of pure functions right like the execution history of this system is not a pure function of its inputs there's a source of entropy a source of Randomness which you do not control which is the network.” —— Will Wilson - 数据一致性的代价:对于一般的 Web 服务器或缓存,挂了可以轻松地销毁 VM 重启;但用户对底层数据极其敏感,“人们对自己的数据可没有那么豁达”。 --- ### [04:03](https://www.youtube.com/watch?v=4fFDFbi3toc&t=243s) 逆向开发哲学:先做确定性仿真,再做真实数据库 FoundationDB 面临的核心挑战在于:他们要做的是一个提供 ACID 强事务保证的分布式数据库。ACID 绝不可能凭空意外产生,做错的方式远比做对的方式多得多;更危险的是,一个系统在常规流程下能跑通,但一旦遭遇意外环境就瞬间崩塌的概率,远大于它在异常下依然保持正确并持续稳定的概率。团队因此得出结论:如果不能彻底解决调试和测试的可重复性难题,根本就不该动手去造数据库。 团队采取的策略堪称疯狂:在最初的整整几年里,FoundationDB 甚至没有碰真正的数据库网络和磁盘交互,而是先研发了一套全确定性的仿真系统(Deterministic Simulation)。在这套仿真环境被调试到无可挑剔、穷尽所有异常之后,团队才加上真正的网络与磁盘通信,将它蜕变为一个真实的生产数据库。 这项工程的疯狂之处在于仿真范围:系统不仅要在单个物理进程内模拟单个节点,而是要在一个物理进程中模拟出一整个由大量相互通信的虚拟进程构成的网络,同时完整模拟这些进程与外部环境(磁盘、操作系统、网络拓扑)的所有交互。 实现这一架构需要克服三大理论与工程挑战: 1. **单线程伪并发(Single-threaded pseudo concurrency)**:系统在概念上必须模拟许多并发事件和它们自以为在进行的网络通信,但绝对不能使用真正的操作系统线程或多进程并发。因为真并发会重新引入线程调度带来的非确定性熵,破坏确定性。 2. **模拟所有外部交互**:所有进程与宇宙打交道的方式(磁盘 I/O、网络传输、时钟等)都必须由软件模拟实现,将环境中的所有随机性都转化为测试框架人为、受控注入的随机性。 3. **被模拟代码本身的确定性**:进程自身的业务逻辑必须是完全确定性的,不能调用未受控的外部系统状态。 - 研发初期的激进决策:“The thing that that the company did was we didn't write a database we started by writing a simulation of a database a totally deterministic simulation and then once we'd exhaustively debugged that we were like okay now we can write a database which is just that plus talking on networks and talking to discs for real.” —— Will Wilson --- ### [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) 打破 C++ 回调地狱:Flow 语言扩展的诞生 在攻关“单线程伪并发”时,团队陷入了艰难的技术选型困境。因为确定性要求,多线程方案被彻底排除;协程在当时存在诸多局限;剩下的唯一底层手段只有“事件回调(Callbacks)”。另一方面,为了追求极致的数据库吞吐与低延迟性能,系统必须使用 C++ 编写。 然而,“C++ 加上纯回调函数无异于人间地狱(a nightmarish hellscape)”,代码的可读性和逻辑推理性会彻底粉碎。团队需要的是高级抽象原语,既能让开发者像写顺序代码一样思考并发,又能在底层编译为单线程、纯回调驱动的状态机。 为此,FoundationDB 创造了 **Flow**。Flow 介于库和新语言之间,是 C++ 的语法超集(附带一个目标代码为 C++ 的预处理编译器)。Flow 引入了基于 Actor 模型的并发语法糖,但物理执行完全由单线程调度器和回调支撑。 ```mermaid flowchart TD accTitle: Flow 编译与执行模型 accDescr: 展示 Flow 源代码通过预编译生成纯 C++ 回调状态机并在单线程调度器中执行的过程 subgraph FlowSource["Flow 源代码 (.actor.cpp)"] ActorCode["actor 语法糖定义<br/>高层并发逻辑 (wait / future)"] end subgraph FlowCompiler["Flow 预处理器 / 编译器"] CodeGen["静态分析并展开状态机<br/>生成对应辅助类与回调函数"] end subgraph OutputCpp["标准 C++ 源码"] direction TB FuncEntry["入口函数: 立即返回 Future&lt;T&gt;"] StateClass["生成的 Actor 状态机类<br/>封装状态参数与单线程回调逻辑"] end subgraph Execution["单线程执行引擎"] EventLoop["单线程事件循环 (Event Loop) 调度回调"] end ActorCode --> FlowCompiler FlowCompiler --> CodeGen CodeGen --> FuncEntry CodeGen --> StateClass FuncEntry -.->|"实例化"| StateClass StateClass --> EventLoop ``` Will 现场展示了一个极简的 Flow 示例——一个异步加法器(Asynchronous Adder): ```cpp ACTOR Future<float> asyncAdd(Future<float> f, float b) { float a = wait(f); return a + b; } ``` 针对这段代码,Will 指出了两个初看极不寻常的特征: 1. **非标准关键字 `ACTOR`**:这并非标准 C++,直接传给标准编译器会报错。它向 Flow 编译器标明这是一个需要被展开为 Actor 状态机的函数定义。 2. **表面上的“类型不匹配”**:签名声明返回 `Future<float>`,但函数体内部却直接写了 `return a + b;`(一个普通的 `float`)。这是因为该函数体并不是最终运行的代码,而是一种声明式描述。Flow 编译器会将其重写为一个崭新的外部函数和一个内部状态机类;当调用 `asyncAdd` 时,外部函数会立刻返回一个 `Future<float>`,该 Future 会在整个异步等待链条执行完成、求值结束的一瞬间就绪(Ready)。 在底层展开的代码中,Flow 会重写原函数,给输入参数加上 `const` 修饰符,并将参数打包传入自动生成的内部状态机类构造函数中,以单线程事件回调的机制完成异步驱动。 - 对底层回调方案的评价:“Callbacks plus C++ is like a nightmarish hellscape.” —— Will Wilson ### [09:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=582s) Flow 编译器实现与基准测试的局限 Will Wilson 详细解释了 Flow 编译器在幕后所做的工作。当一段 Actor 代码被编译时,编译器会完全自动生成一个 C++ 类,且该类的调用会立即返回。Actor 的主体逻辑被拆解并分散在该类的多个方法中:每当遇到等待异步操作结束的 `wait` 语句时,当前方法就会在此处终止,并在对应的 Future 上设置一个回调函数。该回调函数直接指向 Actor 的下一个逻辑片段。随后,它会立即向一个中央调度器(centralized scheduler)让出控制权(yield),以便程序的其他部分能够继续推进。当整个 Actor 的生命周期走到尽头时,它会利用手中持有的 Promise 去履行(fulfill)最开始对外暴露的那个 Future,最后执行对象的自我清理和销毁。 这种设计的优势在于,程序员可以采用完全直观的 Actor 语法编写逻辑,而所有操作都在单线程中执行,同时保持极高的异步并发性与运行效率。 ```mermaid flowchart TD accTitle: Flow 编译与回调流转图 accDescr: 展示 Flow 编译器如何将 Actor 方法拆分并通过中央调度器在单线程中执行异步流转 subgraph Compiler["Flow 编译与生成"] A["Actor 源代码"] -->|"编译生成"| B["C++ 包装类"] B -->|"初始化并立即返回"| C["Future / Promise 对"] end subgraph Runtime["单线程调度执行"] D["Actor 第一段方法"] -->|"遇到 wait"| E["在 Future 上注册回调"] E -->|"Yield 让出执行权"| F["中央调度器"] F -->|"触发回调"| G["Actor 后续方法"] G -->|"完成执行"| H["履行 Promise 并销毁自身"] end C -.-> D ``` Will 随后展示了系统的性能数据,但他坦言大家应当“对其持巨大保留态度”(take with a gigantic grain of salt)。这项测试采用了由前一位演讲者 Joe Armstrong 发明的“环形基准测试”(Ring Benchmark):创建 $N$ 个 Actor 排成一个闭合环,在它们之间依次传递消息并循环 $M$ 次。关于为何不应盲目相信这些对比数据,Will 幽默地环顾会场并解释了两点: > “希望 Joe Armstrong 不在这里,这其实算是一个挺傻的基准测试。” —— Will Wilson 首先,除 Flow 之外的其他测试数据均来自网络上其他人针对各自系统运行的公开结果,虽然假设对方已经尽力优化,但实际运行环境无法考证;其次,环形测试过于简陋,根本无法真实反映分布式 Actor 系统的实际负载。在实践中,当 Actor 内部逻辑越来越复杂、引入更多异步调用时,Flow 的相对性能优势会出现大幅下降。这也是团队着手开发 Flow 2 的主要动力,希望藉此进一步压榨运行效率。 - 环形基准测试逻辑:$N$ 个 Actor 组成环形链路,消息在节点间顺次传递,总共循环传递 $M$ 次。 - 架构现实差异:简单的基准测试无法模拟现实中 Actor 高度异步与复杂状态变更的场景。 --- ### [12:07](https://www.youtube.com/watch?v=4fFDFbi3toc&t=727s) 确定性模拟的构件:网络抽象与随机故障注入 脱离了定制语言编译器后,Will 转向构建确定性模拟框架的核心要素。由于 FoundationDB 在设计之初就是一个跨平台系统,底层与磁盘、网络等硬件交互的接口早已抽象完毕。因此,团队不需要重构系统,只需在原有的 Unix 网络实现与 Windows 网络实现之外,再平行插入一套“模拟网络”(simulated network)代码。 在模拟网络环境下,建立网络连接不会产生实际的套接字调用,而是实例化一个维护内部状态和缓冲区的 C++ 类。当节点发送数据时,该类会在发送端插入延迟模拟传输耗时,随后在接收端模拟排队延迟,再完成字节的内存拷贝,最后通知接收端有数据可读。 在模拟的 `read` 方法中,团队埋入了一个名为 `roll random cloth` 的故障注入机制,用来逼出潜在的代码缺陷。每次尝试从模拟网络读取数据时,系统都会抛掷随机数。如果遭遇“倒霉”的随机结果,系统会继续连环掷骰子触发各种恶劣场景:或是对端直接挂断,或是本端主动断开,亦或是连接发生未知错误并向读取者抛出异常。Will 直言: > “通过这种机制,我们试图排查系统里所有假设网络是完全可靠的代码,而做这种假设是一件非常愚蠢的事。” —— Will Wilson - 跨平台抽象:利用现成的平台接口分离层,无缝接入模拟驱动。 - 模拟网络机制:纯内存缓冲区实现,精准模拟发送侧延迟、接收侧延迟以及数据搬运。 - 故障注入类型:随机连接中断、单向静默断开、底层读取错误等非确定性网络事故。 --- ### [13:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=832s) 确定性的达成:伪随机控制与 1% 重复运行检验 要实现整套模拟框架,最后一道也是最具挑战性的关卡是“确定性”(determinism)。表面上看,让程序具备确定性似乎理所当然,因为开发者通常不会故意编写非确定性的代码,但这种隐患在日常工程中无处不在。最普遍的例子是随机数——例如指数退避(exponential backoff)算法中使用的随机抖动。若要保证确定性,必须确保系统内所有随机数都源自一个开发者完全可控、显式指定种子的伪随机数生成器(PRNG),而该种子本身则作为整个测试程序的初始输入参数。 更为隐蔽的陷阱存在于系统对环境状态的嗅探中。代码中如果出现类似“在 `if` 条件中检查系统当前时间”或者“查询当前磁盘剩余空间”的操作,确定性就会瞬间被粉碎;即使两次运行的输入完全一致,系统的执行轨迹也会彻底分道扬镳。Will 强调,尽管团队内的工程师都接受过严格训练以识别并规避这些代码习惯,但在庞大的工程中依然会屡屡失手。 为了捕获确定性破坏(determinism failure),FoundationDB 引入了一道防线:在所有模拟测试中,抽取大约 1% 的测试任务执行两次。这两次运行输入完全相同的种子和外部事件序列。在运行结束的最后一刻,系统会去比对伪随机数生成器预备生成的“下一个随机数”。如果两个副本输出的值不完全匹配,就证明两次执行在某个中间步骤的分支判断上产生了分歧,进而触发确定性告警并由开发人员追踪定位。虽然这无法穷尽所有确定性漏洞,但确保了违背确定性的逻辑能在早期被揪出。 - 时间与环境非确定性:禁止读取真实的壁钟时间(wall-clock time)、实时磁盘容量或操作系统硬件计数器。 - 种子驱动:将所有非确定性源头收拢至单一 PRNG 种子,使其构成可重放的程序输入。 - 1% 双跑校验机制:在完全相同的参数下跑两遍,运行结束时校验内部 PRNG 状态是否一致。 --- ### [16:01](https://www.youtube.com/watch?v=4fFDFbi3toc&t=961s) 测试用例编排:环形事务不变量与混沌故障场景 当 Actor 运行时、模拟网络与确定性环境三者合一后,系统就获得了在纯软件环境中完全确定性地模拟整个分布式集群交互的能力。团队通过声明式测试文件来挖掘 Bug。一份测试文件核心包含两类要素:系统要达成的目标(负载),以及试图阻止系统达成目标的各类干扰(故障注入)。 在负载方面,测试声明了一个“环形测试”(cycle test)。系统首先在数据库中写入一个闭环的键值对链表(例如 Value 1 指向 Key 2,以此类推),然后以每秒 1000 个事务的并发速率施加负载。每个并发事务都会对数据库中的键值进行修改,但受制于一个全局约束——事务在整体逻辑上必须保持环的完整性,允许改变节点顺序或位置,但链环不能断裂。 ```mermaid flowchart LR accTitle: 环形测试不变量校验逻辑 accDescr: 展示环形键值链路在受到并发事务突变并经历故障注入后,最终通过链环完好性验证 ACID 的过程 A["K1 -> V1 (指向 K2)"] --> B["K2 -> V2 (指向 K3)"] B --> C["K3 -> V3 (指向 K1)"] subgraph Transactions["并发事务变异 (1000 TPS)"] T["原子性 / 隔离性突变"] end A -.-> T B -.-> T C -.-> T T -->|"保持环结构"| PASS["验证通过: ACID 未被破坏"] T -->|"断环 / 伸长 / 缩短"| FAIL["报错: 出现原子性破损或隔离级别冲突"] ``` 这一设计的精妙之处在于提供了一个极易验证的不变量(invariant):如果在测试结束后环发生断裂、变长或变短,就直接证明 ACID 遭到了破坏——要么是事务部分写入导致原子性(Atomicity)破损,要么是事务并发覆盖破坏了隔离性(Isolation)。在这个测试中,由于后续施加了极度严苛的故障注入,团队甚至只预期能成功提交 1% 的事务。 而测试文件中用于破坏系统达成目标的干扰手段则极为残暴,主要包含三类: 1. **随机阻塞(Clogging)与交织(Swizzling)**:系统会伪随机且确定性地阻断部分模拟网络连接,使数据包无法收发。测试中启用了名为“Swizzle”的增强模式。Will 承认: > “交织(Swizzling)基本上可以看作是阻塞(Clogging)的升级版。它会选取一部分网络连接按滚动方式截断,随后以相反的顺序恢复它们;尽管我们完全不理解背后的深层原因,但它在挖 Bug 方面就是比普通阻塞有效得多,这其实挺让人害怕的。” —— Will Wilson 2. **硬件损耗(Attrition)**:在整个 30 秒的测试周期内,系统会随机切断机器电源并在后续恢复,期间总计杀死 10 台机器,任何时刻仅保留 3 台处于开机状态,借此检验集群在极端断电场景下的安全性。 3. **协同变更(Coordination Change)**:这是整个配置中最具破坏性的操作。系统会在混乱流水线中动态触发数据库配置变更,强迫集群在面临网络链路被大面积交错切断、机器接二连三断电重启的极端恶劣环境下,强行执行 Multi-Paxos 共识协议来完成协调节点的交接。 - 环形不变量设计:通过简单的环拓扑检查,无需复杂的外部比对即可在测试尾声直接证伪 ACID 特性。 - 事务预期:在严重干扰下,即便 99% 的事务失败或回滚,只要通过的 1% 满足一致性即算系统正确。 - 复合故障场景:网络阻塞颠倒(Swizzle)、大规模断电重启(Attrition)与一致性协议迁移(Multi-Paxos reconfiguration)在毫秒级时序内并发交织。 ### [19:11](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1151s) 模拟极端故障场景与“愚蠢系统管理员” 在每秒处理上千次事务的高并发压力下,FoundationDB 的仿真框架正在不断寻找 Paxos 协议实现中的潜在漏洞。Will Wilson 提到,系统所做的测试远不止常规的断网或关机,他们还会注入极其恶劣的渐进式故障。例如,仿真环境会把某些机器置于一种“缓慢死亡”的状态——所有后续系统调用(system calls)都有大约 1% 的概率返回错误。通过这种方式,测试团队可以验证集群是否足够智能,能否及时检测出异常节点、对其进行隔离并在其影响扩散到整个集群之前将其销毁,同时也以此检验系统的优雅停机(graceful shutdown)等特性。 此外,FoundationDB 本身具备“位置感知”(locality)的概念,能够识别机架拓扑结构以及广域网(WAN)链路的位置,而仿真环境完全继承并理解这些信息。这让团队可以轻松模拟“瞬间摧毁整座数据中心”的灾难级场景,以检验数据是否真正具备持久性和高可用性。Will Wilson 还幽默地表示,他们还会模拟现实中“绝不可能存在”的“愚蠢系统管理员”(dumb sysadmins): > “Like one of the most fun parts of my job is thinking up new and creative ways of torturing our database and then implementing that in simulation.”(我工作中最有趣的部分之一,就是想出各种新颖且极具创意的方法来折磨我们的数据库,然后在仿真中实现它们。) 在这些模拟管理员失误的场景中,仿真框架能够: - 瞬间原子性地互换两台物理机器的 IP 地址,观察集群路由和连接状态如何应对。 - 瞬间将两台计算机上的数据文件互相拷贝覆盖,或者直接在两者之间对换硬盘,检验这种混乱操作是否会导致数据损坏或丢失。 --- ### [20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) 核心挑战:如何比客户更快地遍历状态空间? 尽管仿真框架极其强大,但确定性仿真测试面临一个本质上的严峻挑战:测试实验室中的计算资源是有限的,测试机群在努力探索所有可能输入与故障模式组成的状态空间;与此同时,真实世界中的客户也在探索同样的空间。Will Wilson 形象地描述了客户的运行环境——他们往往在充满 Bug、容易崩溃、严重超配/欠配(underprovisioned)且配置完全错误的硬件上运行分布式系统,并且在上面执行各种匪夷所思的疯狂操作。最关键的是,一旦系统出现问题,“顺便说一句,如果系统坏了,那就是你的错”。 由于客户的数量及其拥有的机器规模通常比研发实验室多出数个数量级,开发者面临的核心命题是:**如何确保自己在测试环境中遍历错误空间的速度,远快于真实客户遇到这些错误的速度?** > “Another way of thinking about this is you need to find more bugs per CPU hour than the real world by many orders of magnitude, which is hard.”(换个角度来想,你必须比现实世界每 CPU 小时多发现数个数量级的 Bug,这极其困难。) ```mermaid flowchart TD accTitle: 仿真测试与生产环境探索故障空间的对比 accDescr: 比较测试实验室有限资源与生产环境海量客户硬件在探索故障空间上的差异 subgraph LAB["研发测试实验室"] L_MACH["有限的测试集群"] --> L_EXPLORE["确定性仿真探索"] L_EXPLORE --> L_GOAL["目标:提升每 CPU 小时发现 Bug 概率"] end subgraph PROD["生产真实世界"] C_USERS["海量客户群体"] --> C_HARDWARE["错误/欠配/配置混乱的硬件"] C_HARDWARE --> C_CHAOS["执行极端、不可预测的操作"] C_CHAOS --> C_EXPLORE["极速遍历故障空间"] end L_GOAL -.->|"必须大幅领先以提前捕获 Bug"| C_EXPLORE ``` 为了战胜客户环境在规模上的压倒性优势,FoundationDB 采用了多种提升 Bug 触发密度的工程策略: - **大幅提高故障频率**:现实世界中,重负载下的硬盘可能两到三年才损坏一次;而在仿真中,系统让硬盘每两到三分钟就损坏一次。这意味着测试环境单位 CPU 小时内经历的磁盘故障数量比真实世界高出几个数量级,从而能更快暴露磁盘故障处理代码中的缺陷。 - **虚拟时间加速(Speed up time)**:分布式集群在许多时候处于静止等待状态,或者在从故障中恢复时需要等待固定的硬编码超时秒数。在单核计算性能允许的情况下,仿真引擎会直接快进虚拟时钟,让一秒真实时间内流逝大量的“仿真秒”,极大压缩无效等待时间。 --- ### [23:06](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1386s) 变异测试技术:Bugification 除了加快时钟和提升硬件故障率,FoundationDB 采用的另一项关键技术是团队内部称为 **“Bugification”**(Bug 化)的机制。Will Wilson 回顾了早先提到的案例:许多分布式 Bug 属于“无症状 Bug”,即两端代码在契约理解上从一开始就存在分歧,但必须等待某种极其罕见的物理条件才会显现。为了不必被动等待极端罕见的极端事件发生,团队打破了“程序员从不故意改变代码逻辑”的常规,在仿真中主动对代码行为注入随机变异。 `bugif` 本质上是一个宏定义,其工作逻辑是:当系统处于仿真运行状态时,以一个很小的随机概率触发非标准行为(内部结合行号哈希等机制)。通过这种手段,系统可以强制接口暴露出更多潜在合法的边缘行为,防止组件之间的依赖建立在“某个狭窄的常规实现子集”之上。 代码变异的典型应用场景包括: - **颠倒数据包发送顺序**:若常规逻辑是依次发送数据包 A 和数据包 B,宏判定命中后会写成 `if (bugif) { send(B); send(A); }`,以验证接收方是否严格遵循乱序到达的协议规范,而非暗中假设了先后顺序。 - **不完全发送**:在某次网络写入就绪时,故意保留一部分数据不发,仅发送缓冲区中的片段。 - **永久丢弃超时事件**:在判定为 Bugification 运行时,完全抑制超时信号的发送,检验对端是否错误地将超时作为必须到达的控制流依赖。 --- ### [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) 赫斯特指数与级联故障建模 Will Wilson 引入了他极为热衷的一个数学与工程概念——**赫斯特指数(Hurst exponent)**。该概念最早发表于 1951 年《美国土木工程师学会会刊》(*Transactions of the American Society of Civil Engineers*)中由 Harold Edwin Hurst 撰写的论文《水库的长期蓄水能力》(*Long-term storage capacity of reservoirs*)。作为一名被派往埃及研究尼罗河大坝与水库的英国公职人员,Hurst 发现上一代工程师的设计原则表面上看起来很合理:水库的设计指标是足以抵御“百年一遇的洪水”与“百年一遇的干旱”。然而在实际运行中,这种所谓的“百年一遇”灾害大约每 15 年就会发生一次。 问题根源在于,早期的工程师(以及 2008 年金融危机前的许多金融从业者)错误地假设每天“下雨”或“不下雨”是完全独立的随机试验,事件之间互不相关。但在现实中,若周二下雨,周三下雨的概率显然高于普通基准概率——事件绝非相互独立。高斯正态分布基于独立试验假设,其尾部衰减极快;而赫斯特指数正是用来量化这种“非独立性”的工具。当赫斯特指数大于 0.5 时,系统服从具有“重尾”(heavy tails)特征的稳定帕累托分布(stable Paretian distributions,其参数 $\alpha$ 正好是赫斯特指数的倒数,高斯分布对应 $\alpha=2$ 且赫斯特指数为 0.5)。重尾分布意味着现实中遭遇极高 $\sigma$(标准差)极端事件的概率,远超朴素正态分布的预期。 > “The answer is hardware failures are not independent random events. Okay? You all know this in your guts, right? Like if a hard drive fails in a rack, what is the first thing you do? Oh my god, check every other hard drive in that rack!”(答案是:硬件故障并不是独立的随机事件。大家打心底里都知道这一点,对吧?比如机架里有一块硬盘坏了,你的第一反应是什么?天哪,赶紧检查那个机架上的所有其他硬盘!) 一块硬盘故障,可能意味着整批硬件质量有瑕疵、机房维护操作不当或者数据中心湿度异常。多节点级联故障在统计学上极为常见,但在物理硬件测试中极难复现与构造。而在确定性仿真环境中,FoundationDB 可以自由调节赫斯特指数,人为制造大量高密度的多节点级联关联崩溃,以此测试系统在真实极端环境下的生存韧性。 - **庞大的测试规模**:结合时间加速、故障注入与 Bugification,FoundationDB 估算他们已经执行了相当于真实世界**数万亿 CPU 小时**的测试。 - **日常回归吞吐量**:利用测试集群,团队每晚运行 **500 万到 1000 万次** 独立的仿真测试。 - **场景跨度**:每次仿真测试模拟整个分布式集群在 5 分钟到 1 到 2 个小时内的完整运作过程,该机制已稳定运行多年。 --- ### [28:58](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1738s) 仿真带来的代价:回调地狱与调试灾难 在确定性仿真带来巨大测试收益的同时,Will Wilson 话锋一转,指出这也带来了一个极其棘手的负面代价:“我们彻底毁掉了调试”(we've totally broken debugging)。 在传统的异步编程模型中,代码中往往充斥着层层嵌套的事件回调函数(callbacks),在单机环境下单步调试这种代码本就极其痛苦。如果在一个完全由事件驱动、内部全由回调交织而成的确定性仿真系统里,用传统断点调试器去排查由多个“充斥着回调的怪物节点”组成的分布式死锁或状态错误,其复杂度与认知负荷将呈指数级爆炸。常规单步调试工具面对这种高度交织的事件仿真基本处于失效状态,必须寻求全新的架构与语言层支持来解决这一困局。 ### [29:25](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1765s) 调试困境与基于确定性模拟的“printf 战术” 当所有节点与模拟器逻辑全都塞进同一个进程时,传统的交互式调试变得极其反人类。不仅有多个相互协作的节点在同一个挂载的进程里共存,外层还包裹着整套竭力欺骗节点“它们正通过网络向彼此通信”的模拟框架代码。在调用栈里逐帧单步跟踪极为艰难,Will Wilson 坦言团队里虽然有两三位神级工程师能硬生生在栈里向下深潜两三层单步单步排查并让全组叹为观止,但对其余普通工程师而言根本不可行。 最终剩下的调试利器退化到了看似最原始的手段——打日志(printf)。Will Wilson 直白地承认: > “So what you're left with is basically printf, which sounds pretty horrible and barbaric, and I'll be honest it is, but it's actually not that bad when you have deterministic simulation.” 在具备确定性模拟的前提下,printf 的威力被彻底释放。只要用完全相同的输入重新跑模拟,所有事情就会在完全相同的时刻、以完全相同的顺序发生。工程师不需要打印海量垃圾日志,而是可以针对“已知下次必定触发”的精确前置条件添加针对性日志,一层层将 printf 推进到代码深处,像步步紧逼一样把 Bug 逼入死角并彻底剿灭。修完之后再次回放,还能立即验证 Bug 是否真的不再重现。 --- ### [30:37](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1837s) 模拟框架的盲区与残酷的物理集群 “Sinkhole” 确定性模拟虽然强大,但依然存在一种终极噩梦:模拟本身是错误的。这通常来自两个方向: 1. **残酷程度不够**:现实世界中存在某种极其诡异的网络或硬件故障模式,但模拟器从未构造过这种模式。 2. **对操作系统契约理解有误或 OS 本身有 Bug**:比如团队自以为理解了 `fsync` 的语义,但实际行为存在出入;或者跨平台移植时,同名系统调用在不同 OS 上的底层保证存在微妙差异。 为了捕获这类超出模拟器认知的真实漏洞,FoundationDB 打造了一个专门的后备物理测试集群——**Sinkhole**。该集群由多块配备 ECC 内存的小型服务器主板组成,彼此通过五类线(CAT 5)和交换机互联。最致命的设计在于:交换机和所有主板全部插在可编程网络电源(PDU)上,由脚本控制整夜对整套集群疯狂切断和恢复电源。 ```mermaid flowchart TD accTitle: Sinkhole 物理混沌测试集群架构 accDescr: 展示可编程电源控制主板与交换机断电重启以测试掉电安全性的硬件拓扑架构 subgraph PowerCtrl["自动化控制层"] PDU["可编程网络电源<br/>(PDU / 脚本轮流断电)"] end subgraph HardwareCluster["Sinkhole 硬件环境"] SW["网络交换机<br/>(模拟物理网络断联)"] MB1["真实服务器主板 1<br/>(ECC RAM + SSD)"] MB2["真实服务器主板 2<br/>(ECC RAM + SSD)"] MB3["真实服务器主板 3<br/>(ECC RAM + SSD)"] end subgraph StackUnderPower["被测对象"] FDB["FoundationDB 数据库进程<br/>(验证掉电安全性)"] end PDU -.->|"高频断电 / 烧毁风险"| SW PDU -.->|"高频断电 / 极损 SSD"| MB1 PDU -.->|"高频断电 / 极损 SSD"| MB2 PDU -.->|"高频断电 / 极损 SSD"| MB3 SW --- MB1 SW --- MB2 SW --- MB3 MB1 & MB2 & MB3 --- FDB ``` 尽管硬件损耗极其惨烈——市面上的可编程电源质量堪忧,连续开关两天就会报废烧毁,团队为此用坏了上百个电源,高速断电对 SSD 也是极具破坏性的损耗——但在 FoundationDB 数据库自身的代码上,Sinkhole 从未炸出过任何 Bug。这反向证明了模拟器在覆盖系统边界上做得相当出色。 - **硬件配置**:小型真实服务器主板、ECC 内存、千兆网线与交换机,全部由可编程网络 PDU 供电。 - **运行方式**:数据库跑负载的同时,全自动脚本通宵交替切断/接通主板与交换机电源。 - **硬件战损**:网络可编程电源几天就烧掉一批,损耗了上百台;SSD 在高频掉电下故障率极高。 - **测试战果**:在 FoundationDB 自身代码中从未发现过掉电安全 Bug。 --- ### [33:00](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1980s) 第三方依赖的惨痛教训:弃用 ZooKeeper 与 APT 的“fsync 惨案” 尽管自身代码抗住了掉电考验,但 Sinkhole 却无情揪出了第三方软件的缺陷。非 Flow 语言编写、无法进入确定性模拟的外部代码,构成了系统的致命盲区。 在 FoundationDB 早期版本中,团队曾引入 ZooKeeper 来维护集群协调状态。在 Sinkhole 的早期雏形测试中,他们直接抓到了 ZooKeeper 的一个严重掉电安全性 Bug。虽然上报后 Apache 官方修复了该问题,但这段惊魂经历让团队彻底丧失了对外部依赖的安全感。Will Wilson 提到,这一创伤促使他们做出激进决定:直接把 ZooKeeper 彻底剥离出技术栈,完全基于 Flow 从零编写了一套自研 Paxos 实现,将其完全置于确定性模拟的保护伞之下;顺带还省去了部署和维护 Java 运行时的巨大麻烦。 另一次荒谬的事故发生在包管理工具上。团队在 Sinkhole 的多台机器上安装数据库并启动运行,接着对集群进行疯狂断电。重启后,其中一个进程竟然无法拉起。排查后发现,底层数据文件由于正确调用了持久化刷盘与日志,完好无损地躺在磁盘上;然而数据库的配置文件却彻底损坏或丢失了。罪魁祸首竟然是 Debian/Ubuntu 的包管理器 `apt` 在写入配置时未调用 `fsync`。进程重启后判定“没有配置文件却有一堆数据文件”,误以为状态错乱而主动 Panic。 --- ### [34:31](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2071s) 人机关系的异化与打破研发“心流”的十万次模拟 在技术分享的收尾阶段,Will Wilson 探讨了分布式测试在面对天文数字般的故障状态空间时,工程团队面临的深层困惑与未来方向。他幽默地感慨技术开发似乎进入了某种“人机关系的新阶段”: > “I feel like we've entered like a new phase in the relationship between man and machine, because if you look at the workflow of one of us, it looks like: you make some changes to the program, you recompile, and then you run like 10,000 simulations to see if you did something obviously dumb, and then you hope that if you did something subtly dumb, you'll get caught that night when we run 10 million.” 每次写完几行代码,跑 10,000 次模拟需要等上一两分钟甚至更久。这彻底打破了程序员沉浸式的 Coding 状态(Flow state)。很多人之所以喜欢解释型语言,就是为了省去哪怕几秒钟的编译时间,而 FoundationDB 却把单次调试循环拉长到了数分钟之久。Will Wilson 指出,增加更多硬件资源也许能显著压缩等待时长,从而反常识地大幅拯救工程师的日常生产力。 此外,为了防范模拟器自身的“盲点”引发类似抗药性的现象,团队还构想过以下手段: - **专职 Bug 注入工程师**:雇佣专人向代码库故意植入隐秘 Bug,测试它们能否穿透模拟框架;若能穿透,则视为对模拟器框架本身的 Bug 报告。 - **双重模拟框架**:建立两套原理各异的模拟器。一套用于日常敏捷开发回归,另一套专门在发布前夜运行上千万次模拟测试,杜绝单一模拟器模式下的“抗药性”。 - **加码真实硬件测试**:虽然面对硬件极其痛苦(有同事戏言“编程除了跟网络、磁盘和电源打交道的部分很好玩,其余全都很痛苦”,结果现在整天全在摆弄硬件和被烧毁的电源),但适度增加像 Sinkhole 这样的真实物理混沌注入,依然是弥补纯软件模拟盲区不可或缺的防线。 --- ### [38:18](https://www.youtube.com/watch?v=4fFDFbi3toc&t=2298s) 现场问答:模拟器对抗 Netflix Chaos Monkey 与确定性的“全知全能” 在演讲后的问答环节,有观众提问:这种测试方式与 Netflix 的混沌工程(Chaos Army / Chaos Monkey)有何不同?是否考虑过直接在生产环境中制造混乱? Will Wilson 首先重申了架构基础:模拟测试运行的正是纯粹的**生产环境核心代码**,唯一的区别是剥离了真正对接物理磁盘与物理网络的底层系统调用胶水层。在比较确定性模拟与生产环境混沌测试的优劣时,Will Wilson 深刻剖析了模拟测试独有的上帝视角: > “The benefit of simulation is you can do many, many more different types of things, and you can generally be far more brutal and far more like calculatedly evil. Like in a real production environment, you don't have like omnipotent evil Godlike power to like stop and start network connections in the most inconvenient possible way, or to like do what you know is like the hard case for Paxos and like deliberately do that to try and screw with it.” 在真实生产环境搞破坏,系统无法拥有这种“全知全能的邪恶力量”,去在最刁钻的时间点精准掐断网络,或者专门针对 Paxos 的极限 Corner Case 实施定向破坏。然而真实物理测试的优势在于能发现软件模型未曾预料的硬件异常,生产客户所使用的特定磁盘、网卡也可能存在未知的固件隐患,这恰恰是软件模拟无法感知的。因此两种方案各有千秋,兼收并蓄才是最稳健的体系。会议在对 Hurst 统计学指数相关问题的简短交谈与全场致意中落下帷幕。 ## Notable quotes > [24:52](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1492s) The answer is hardware failures are not independent random events. Okay? You all know this in your guts, right? Like if a hard drive fails in a rack, what is the first thing you do? Oh my god, check every other hard drive in that rack! — Will Wilson > [20:42](https://www.youtube.com/watch?v=4fFDFbi3toc&t=1242s) Another way of thinking about this is you need to find more bugs per CPU hour than the real world by many orders of magnitude, which is hard. — Will Wilson > [07:16](https://www.youtube.com/watch?v=4fFDFbi3toc&t=436s) Callbacks plus C++ is like a nightmarish hellscape. — Will Wilson ## Mentioned Will Wilson, FoundationDB, Flow, Joe Armstrong, Multi-Paxos, Paxos, Harold Edwin Hurst, Sinkhole, Apache ZooKeeper, Debian, Ubuntu, APT, Netflix, Chaos Monkey ## Video description Debugging highly concurrent distributed systems in a noisy network environment is an exceptionally challenging endeavor. On the one hand, evaluating all possible orders in which program events can occur is a task ill-suited to human cognition, rendering a pure analytic understanding of the control flow of such a system beyond the reach of any individual programmer. On the other hand, a more “empirical” approach to the task is also fraught with difficulty, as the dependence of severe bugs on precise timings or transient network conditions makes every part of the debugging cycle – from bug replication to verification of a fix – a Sisyphean labor bordering on the impossible. One approach which has been developed to ameliorate this situation is that of deterministic simulation, wherein the hardware components of the system – including hard disks, network links, and the machines themselves – are replaced in testing with software which fulfills the contracts of those systems, but whose state is completely transparent to the developer. This enables the simulation of a wide diversity of failure modes including network failures, disk failures or space exhaustion, unexpected machine shutdown or reboot, IP address changes, and even entire datacenter failures. Moreover, once a particular pattern of failures has been identified which uncovers a bug, the determinism property of the simulation means that the exact same series of events can be replayed an indefinite number of times, greatly facilitating the debugging process, and providing confidence when a bug has been fixed. Attendees of this talk will gain an understanding of the benefits, drawbacks, and tradeoffs involved in implementing a deterministic simulation framework, with frequent reference both to theory and to real-world engineering experience gleaned from applying this method to a complex distributed system. Attendees will also learn about language features which aid in the development of such a framework. Will Wilson FoundationDB Will Wilson works on the engineering team at FoundationDB (https://foundationdb.com). Will started his career in biotechnology, leading a successful R&D effort in spinal cord injury diagnostics, currently undergoing commercialization by a company he co-founded. Since then, Will has worked in a variety of technical and business roles at data science and data virtualization startups. Will has a degree in math and philosophy from Yale. [Source](https://www.youtube.com/watch?v=4fFDFbi3toc)

Source quotes

[24:52] Will Wilson: The answer is hardware failures are not independent random events. Okay? You all know this in your guts, right? Like if a hard drive fails in a rack, what is the first thing you do? Oh my god, check every other hard drive in that rack! [20:42] Will Wilson: Another way of thinking about this is you need to find more bugs per CPU hour than the real world by many orders of magnitude, which is hard. [7:16] Will Wilson: Callbacks plus C++ is like a nightmarish hellscape.