3Blue1Brown拆解全连接神经网络 逾万参数依托矩阵运算实现模式识别
3Blue1Brown
神经网络并非神秘黑盒,其本质是由权重和偏置参数化的高维复合函数,通过多层线性代数运算与非线性激活实现特征分层抽象。
AI-assisted summary of But what is a neural network? | Deep learning chapter 1 — original source. Check the original for full context.
Source published:
Key ideas
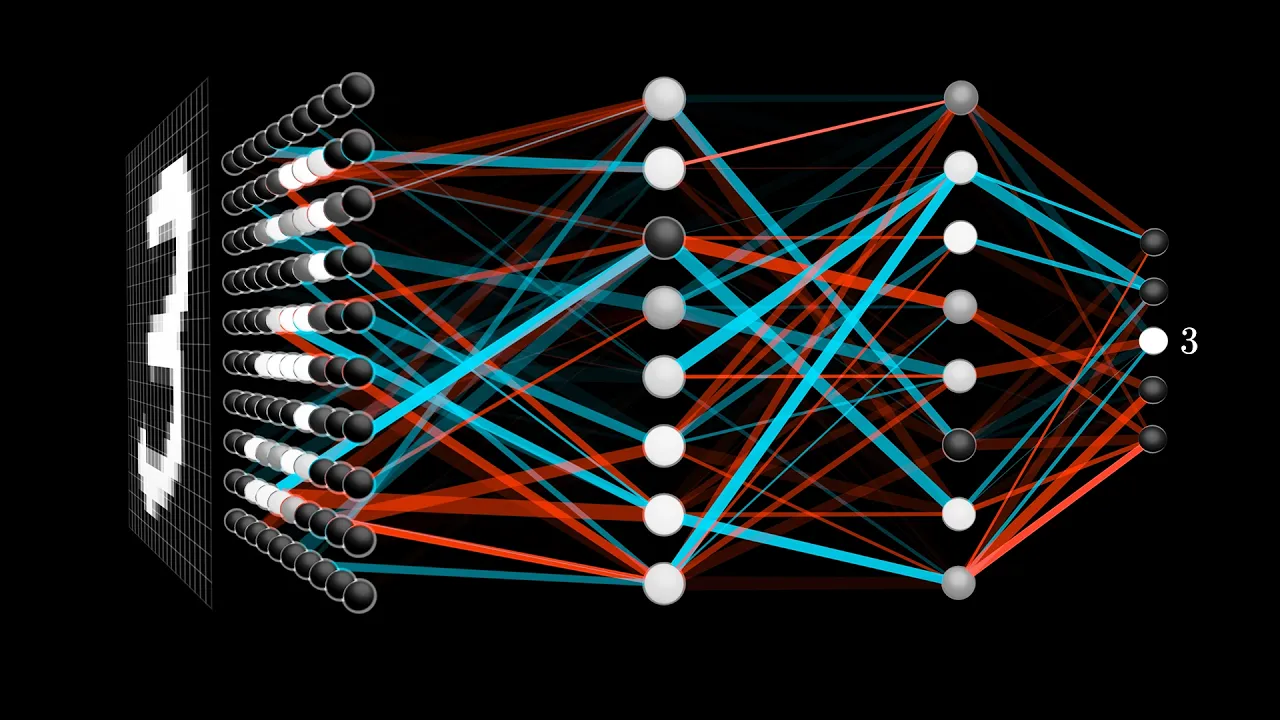
- 本期视频以 28×28 像素手写数字识别为切入点,通过拆解包含 784 个输入神经元、两层各 16 个隐藏神经元及 10 个输出神经元的全连接前馈神经网络,建立起神经网络的基础数学架构。 (1:07)
- 一个看似简单的四层手写数字识别网络包含近 13,000 个权重与偏置参数,所谓的机器学习本质上就是让计算机通过优化算法自动寻找这批高维参数的最优配置。 (10:38)
- 现代神经网络借助线性代数将逐个神经元的线性加权与偏置紧凑表达为矩阵向量形式 $a^{(1)} = \sigma(W a^{(0)} + b)$,这不仅在概念上清晰,更能借助底层硬件优化大幅提升工程计算速度。 (13:26)
- 特邀嘉宾 Lisha Li 指出,早期模拟生物神经元抑制与兴奋状态的 Sigmoid 函数在深层网络中极难训练,现代深度学习已广泛转向计算极其简便且收敛更快的 ReLU 函数。 (16:27)
Detailed notes
## Background 该视频由知名数学科普频道 3Blue1Brown 于 2017 年 10 月 5 日发布在 YouTube 平台上。视频简介指出,这是其深度学习系列的第一章,旨在探讨神经元的本质、网络设计为多层结构的原因以及驱动整个系统运转的底层数学原理。
## TL;DR 视频以识别 28×28 像素手写数字为具体任务,由浅入深地拆解了经典全连接前馈神经网络的基本架构与数学本质。作者将神经元定义为保存激活值的容器,阐明了多层结构逐级抽象几何特征的直觉逻辑,并详细剖析了加权求和、偏置设定以及 Sigmoid 挤压函数的计算机制。随后,内容引入线性代数将整层计算紧凑表示为矩阵与向量形式,指出该网络本质上是一个由近 13,000 个参数构成的复合映射函数,并在片尾与嘉宾探讨了现代深度学习从 Sigmoid 转向 ReLU 激活函数的技术原因。
## Atmosphere & style 整部内容散发着 3Blue1Brown 标志性的典雅、沉静与清晰之美,精致直观的动态数学可视化消解了高维计算的冰冷感。主讲人 Grant Sanderson 的讲解语调温和、循序渐进,善于将复杂的算法拆解为人人皆可理解的认知常识,既有对数学本质的严谨敬畏,又穿插着恰到好处的幽默打趣。片尾与领域专家的轻松对谈则进一步拓宽了工程视界,让观者在层层递进的逻辑推导中感受到一种豁然开朗的纯粹智性愉悦。
## Bulletin - [01:07](https://www.youtube.com/watch?v=aircAruvnKk&t=67s) 本期视频以 28×28 像素手写数字识别为切入点,通过拆解包含 784 个输入神经元、两层各 16 个隐藏神经元及 10 个输出神经元的全连接前馈神经网络,建立起神经网络的基础数学架构。 - [10:38](https://www.youtube.com/watch?v=aircAruvnKk&t=638s) 一个看似简单的四层手写数字识别网络包含近 13,000 个权重与偏置参数,所谓的机器学习本质上就是让计算机通过优化算法自动寻找这批高维参数的最优配置。 - [13:26](https://www.youtube.com/watch?v=aircAruvnKk&t=806s) 现代神经网络借助线性代数将逐个神经元的线性加权与偏置紧凑表达为矩阵向量形式 $a^{(1)} = \sigma(W a^{(0)} + b)$,这不仅在概念上清晰,更能借助底层硬件优化大幅提升工程计算速度。 - [16:27](https://www.youtube.com/watch?v=aircAruvnKk&t=987s) 特邀嘉宾 Lisha Li 指出,早期模拟生物神经元抑制与兴奋状态的 Sigmoid 函数在深层网络中极难训练,现代深度学习已广泛转向计算极其简便且收敛更快的 ReLU 函数。
## Key takeaways - [00:04](https://www.youtube.com/watch?v=aircAruvnKk&t=4s) 人类视觉系统能够瞬间将不同笔迹的 28×28 像素低分辨率手写数字归纳为抽象概念,但对传统规则编程而言,从像素灰度直接映射到分类数字是一项极其困难的任务。 - [01:07](https://www.youtube.com/watch?v=aircAruvnKk&t=67s) 本教学模型采用四层全连接前馈神经网络,输入层为 784 个像素神经元,中间设计两个各含 16 个神经元的隐藏层,输出层由对应数字 0 到 9 的 10 个神经元组成。 - [02:42](https://www.youtube.com/watch?v=aircAruvnKk&t=162s) 在严格的数学语境中,神经元本质上是存放特定实数的容器;在输入端,其存储的激活值代表该像素的灰度强度(0 代表纯黑,1 代表纯白)。 - [05:31](https://www.youtube.com/watch?v=aircAruvnKk&t=331s) 多层网络的直觉在于实现逐层分层抽象:浅层识别微小边缘与局部笔划,中层将边缘组合为圆环或直线等复合组件,顶层再根据组件组合敲定最终数字分类。 - [08:38](https://www.youtube.com/watch?v=aircAruvnKk&t=518s) 前一层神经元对后一层神经元的连接强弱由权重(Weight)决定,若将各连接权重可视化为像素网格,可通过正负权重的组合实现特定几何边缘的选择性检测。 - [08:38](https://www.youtube.com/watch?v=aircAruvnKk&t=518s) 加权求和的结果可通过 Sigmoid 函数挤压到 0 至 1 的实数区间,以保证输出数值符合下一层神经元激活值的规范定义。 - [10:38](https://www.youtube.com/watch?v=aircAruvnKk&t=638s) 偏置(Bias)相当于设置了神经元被激活的阈值,用于决定加权和需要达到多高时该神经元才会开始产生有意义的激活响应。 - [10:38](https://www.youtube.com/watch?v=aircAruvnKk&t=638s) 在示例网络中,仅输入层到第一隐藏层就包含 784×16=12,544 个权重及 16 个偏置,整个网络累计拥有近 13,000 个需要通过数据进行训练的可调节参数。 - [13:26](https://www.youtube.com/watch?v=aircAruvnKk&t=806s) 借助线性代数,整个层间的前向传播可紧凑地记为 $a^{(1)} = \sigma(W a^{(0)} + b)$,这种矩阵向量运算形式在现代计算库中得到了深度硬件加速。 - [15:17](https://www.youtube.com/watch?v=aircAruvnKk&t=917s) 从宏观视角审视,整个神经网络本质上是一个接收 784 维向量输入、吐出 10 维置信度向量输出的高维确定性数学复合函数。 - [17:03](https://www.youtube.com/watch?v=aircAruvnKk&t=1023s) 虽然 Sigmoid 激活函数在直觉上契合生物抑制与兴奋模型,但由于其在深层网络中容易导致训练困难与梯度消失,现代网络通常优先采用形式更简单的 ReLU(线性整流单元)。
## Detailed walkthrough ### [00:04](https://www.youtube.com/watch?v=aircAruvnKk&t=4s) 视觉识别的直觉与计算机视角的困境
手写数字识别对人类大脑来说是一件微不足道的小事。哪怕是一个写得极其潦草、在低至 28×28 像素的极低分辨率下渲染出来的数字“3”,普通人的视网膜与大脑皮层也能不假思索地在瞬间辨认出它。即便把几个完全不同字迹的“3”摆在一起,虽然它们在每个像素位置上的具体明暗数值千差万别,人类眼睛中被激发的感光细胞也大不相同,但视觉皮层仍能不可思议地将这些不同的信号抽象并解析为同一个概念,同时将其他数字准确归类为截然不同的符号。
这种感知上的举重若轻掩盖了其计算本质上的极度复杂。正如 3Blue1Brown 所指出的那样:“But if I told you, hey, sit down and write for me a program that takes in a grid of 28x28 pixels like this and outputs a single number between 0 and 10, telling you what it thinks the digit is, well the task goes from comically trivial to dauntingly difficult.”(但如果我让你坐下来写一个程序,接收这样一个 28×28 的像素网格,然后输出一个 0 到 10 之间的数字来告诉你它认为这是几,这项任务瞬间就会从近乎滑稽的简单变成令人望而生畏的困难。)面对这种挑战,传统的规则编程几乎束手无策,这正是机器学习和神经网络展现力量的舞台。
- 输入分辨率:28×28 像素灰度网格 - 输出目标:识别出 0 到 9 对应的具体数字 - 人脑机制:不同感光细胞激发,经由视觉皮层归纳为统一高阶概念
---
[01:07](https://www.youtube.com/watch?v=aircAruvnKk&t=67s) 神经网络的探索目标与基础架构设定
当下人工智能与机器学习的概念早已铺天盖地,但本系列的核心目标并非渲染流行词,而是剥离掉那些浮夸的修辞,在不预设受众拥有专业背景的前提下,将神经网络呈现为纯粹、优美且直观的数学构造。整个讲解分为两部分:首先建立网络的基本架构,理解信息如何流动;随后探讨网络究竟是如何进行所谓的“学习”的。
为了建立扎实的理解,讲解聚焦于最基础、无额外修饰的传统全连接前馈神经网络,并以手写数字识别这一经典问题为抓手。尽管近年来各类新型架构层出不穷,但这种最质朴的形态不仅是理解前沿变体的绝对基石,而且本身就蕴含着足够丰富的数学复杂度。
```mermaid flowchart LR accTitle: Neural Network Basic Architecture accDescr: Information flows through an input layer, two hidden layers, and an output layer. subgraph Input["输入层"] I["784 个像素神经元<br>(28×28 灰度值)"] end subgraph Hidden["隐藏层"] H1["隐藏层 1<br>(16 个神经元)"] H2["隐藏层 2<br>(16 个神经元)"] end subgraph Output["输出层"] O["10 个输出神经元<br>(数字 0 到 9)"] end I --> H1 H1 --> H2 H2 --> O ```
- 输入层:包含 784 个神经元(对应 28×28 个图像像素) - 隐藏层:共 2 层隐藏层,每层设计为 16 个神经元(便于可视化与分层递进的经验设计) - 输出层:包含 10 个神经元,各自映射 0 至 9 的候选分类
---
[02:42](https://www.youtube.com/watch?v=aircAruvnKk&t=162s) 什么是神经元?激活值的数学定义
虽然神经网络受生物大脑启发,但在数学与计算机科学的严格语境中,必须剥离生物学的隐喻。在当前模型中,一个“神经元”(neuron)本质上只是一个用来存放数字的容器,具体而言,存放的是一个介于 0 到 1 之间的实数。
在输入端,28×28 的图像包含 784 个像素,每个像素对应输入层的一个神经元。神经元内存储的数字表示对应像素的灰度值:纯黑像素对应数值 0,纯白像素对应数值 1,不同深浅的灰色则平滑分布在 0 和 1 之间。这个被保存在神经元里的数值被称为它的“激活值”(activation)。在视觉上,我们可以把激活值想象为灯光的亮度——数值越接近 1,该神经元亮起的光芒就越耀眼。
输出层的运作逻辑与此完全相同:10 个神经元各自持有 0 到 1 之间的激活值,代表整个系统对当前图像到底属于 0 到 9 中哪一个数字的置信度。中间隐藏层的神经元同样持有激活值,前一层的激活状态按照特定规律层层递推,决定后一层的激活状态。
- 神经元本质:承载 [0, 1] 区间内单一浮点数的数学容器 - 激活值(Activation):代表灰度强度或分类置信度的量度 - 图像到神经元的映射:纯黑为 0.0,纯白为 1.0
---
[05:31](https://www.youtube.com/watch?v=aircAruvnKk&t=331s) 分层抽象的直觉:为何网络需要多层结构?
在深究具体的数学公式之前,需要从根本上回答一个问题:为什么多层堆叠的网络结构有希望表现出某种“智能”?人类在识别手写数字时,通常不会死板地比对每个像素,而是自发地将图像拆解为更抽象的几何部件。例如,数字“9”通常由顶部的圆环与右侧的竖线组合而成;数字“8”也是顶部带有圆环,但在底部连着另一个圆环;数字“4”则由三条特定的直线段拼接而成。
基于这种人类认知模式,我们对隐藏层建立了一种极为自然的理想化预期。正如 3Blue1Brown 所构想的那样:“Now in a perfect world, we might hope that each neuron in the second to last layer corresponds with one of these subcomponents, that anytime you feed in an image with, say, a loop up top, like a 9 or an 8, there's some specific neuron whose activation is going to be close to 1.”(在一个理想的世界里,我们可能会希望倒数第二层的每个神经元都对应于这些子组件之一;每当你输入一个图像,比如带有顶部圆环的 9 或 8 时,都会有某个特定神经元的激活值接近于 1。)
这种抽象还可以进一步向下分解:圆环本身是由多条更微小的局部边缘拼接而成的;一条长直线也可以被视作一组连续小边缘构成的特定纹理。若能让第一层隐藏神经元负责识别微小的局部边缘,第二层隐藏神经元负责将这些边缘组合为圆环或笔画,最后一层就能自然地根据子组件的组合来敲定最终的数字。这种分层递进不仅适用于图像识别,也普遍存在于各种智能任务中(如语音识别中将原始声波切分为音素、音节、单词,最终提炼为高阶语意)。
```mermaid flowchart TD accTitle: Hierarchical Abstraction in Pattern Recognition accDescr: Pixels are grouped into edges, edges form components, and components define digits. subgraph Level1["底层像素"] P["原始 784 像素网格"] end subgraph Level2["浅层几何特征"] E["微小边缘与局部笔划"] end subgraph Level3["中层组合特征"] C["复合结构 (如顶部圆环、长坚线)"] end subgraph Level4["顶层分类"] D["完整数字判定 (如数字 9)"] end P --> E E --> C C --> D ```
---
[08:38](https://www.youtube.com/watch?v=aircAruvnKk&t=518s) 边缘检测与权重:加权求和及 Sigmoid 挤压
为了让前一层神经元能够激活后一层表示特定特征的神经元,网络必须具备可以调节的“旋钮”或“参数”。假设第二层的某个神经元专职检测图像中某一特定区域是否存在一条边缘,那么网络应该通过何种机制来实现这种选择性识别?
最直接的方法是给该神经元与输入层每个神经元之间的每一根连接赋予一个特定的数值,称为“权重”(weight)。随后,计算输入层所有神经元激活值的加权求和(weighted sum)。如果把所有输入权重也排布为一个与原图相同的 28×28 网格,用绿色代表正权重、红色代表负权重,其运作机制就会极其清晰: 1. 将无关区域的所有连接权重设为零,这样加权求和就完全忽略了该区域; 2. 在关注的区域内赋予正权重,这样只要该区域有亮像素,加权求和的值就会增大; 3. 如果希望精准检测边缘,还可以在目标边缘的紧邻边缘区域赋予负权重。只有当中心明亮而周围黑暗时,加权求和的结果才会达到峰值;若周围区域同样明亮,正负项互相抵消,求和值就会被压低。
```mermaid flowchart LR accTitle: Weighted Sum and Activation Flow accDescr: Pixel activations are weighted and summed, then passed through a sigmoid function. A["前一层各激活值 (a_i)"] -->|"对应权重 (w_i)"| B["加权求和 Σ (w_i * a_i)"] B --> C["Sigmoid 激活函数 σ(z)"] C --> D["下一层神经元激活值 (0 到 1)"] ```
计算得到的加权求和可能是一个任意大小的正数或负数。然而根据神经元的定义,下一层的激活值必须规整在 0 到 1 之间。因此,必须将这个求和结果输入到一个能够将整条实数轴“挤压”(squish)至 [0, 1] 区间的数学函数中。在经典神经网络中,最常用的变换就是 Sigmoid 函数(亦称逻辑斯蒂曲线,Logistic curve):当输入为极大的正数时,输出无限趋近于 1;当输入为极大的负数时,输出无限趋近于 0;而在 0 附近时,输出平滑过渡。
[10:38](https://www.youtube.com/watch?v=aircAruvnKk&t=638s) 偏置(Bias)的作用与网络参数规模
神经元的激活值(Activation)在本质上是其对应加权和(Weighted Sum)正向程度的一种度量:当输入非常负时,通过 Sigmoid 函数压缩后会无限接近 0;输入非常正时则接近 1,且数值在输入为 0 附近平稳上升。然而在实际任务中,人们往往不希望神经元仅仅因为加权和大于 0 就被点亮。例如,若希望某个神经元仅在加权和大于 10 时才产生显著响应,就必须为它设定一种“倾向于保持静止”的倾向。为了实现这一点,可以在将加权和送入 Sigmoid 函数之前减去 10(即加上 -10)。这个额外添加的常数被称为“偏置”(Bias)。正如 Grant Sanderson 所概括:“权重告诉你第二层中的这个神经元正在捕捉何种像素模式,而偏置则告诉你加权和需要达到多高,该神经元才会开始产生有意义的激活。”(“So the weights tell you what pixel pattern this neuron in the second layer is picking up on, and the bias tells you how high the weighted sum needs to be before the neuron starts getting meaningfully active.”)
```mermaid flowchart LR accTitle: 单个神经元的计算流程 accDescr: 前一层激活值与权重相乘求和,加上偏置后经由 Sigmoid 函数输出该神经元的激活值。 subgraph Input ["上一层输入"] A["激活值向量 a"] end subgraph Calc ["线性计算与偏移"] W["加权求和: W · a"] B["加上偏置: + b"] end subgraph Activation ["非线性激活"] S["Sigmoid 函数: σ(...)"] Out["当前神经元激活值 a'"] end A --> W W --> B B --> S S --> Out ```
每一个神经元都对应着繁重的参数量。第二层的 16 个隐藏神经元中,每一个都要与第一层的全部 784 个像素神经元相连,这意味着单是这一层之间就存在 784 × 16 个权重以及 16 个偏置。沿着网络向后推进,其他层与层之间同样布满了海量的权重与偏置连接。将整个示例网络所有层之间的参数累加起来,总共包含将近 13,000 个权重和偏置。所谓的机器学习或网络训练,正是让计算机自动寻找到这 13,000 个“旋钮与转盘”的合适设置,使整个系统能够切实解决手头的问题。
- 第一层到第二层包含 784 × 16 = 12,544 个权重,以及 16 个独立的偏置。 - 整个四层手写数字识别网络累计拥有近 13,000 个可调节参数。 - 设想纯靠人工手动去逐个调节这 13,000 个参数虽然“既有趣又有些令人毛骨悚然”,但探究每个参数的具体物理意义,能让人在网络表现失常或意外生效时,拥有清晰的排查与调整切入点,避免把网络当作不可解释的黑盒。
[13:26](https://www.youtube.com/watch?v=aircAruvnKk&t=806s) 线性代数表达:矩阵与向量的紧凑表示
如果为每一个神经元逐个书写加权求和与偏置的标量公式,数学表达会变得极其繁琐。在神经网络的标准文献与工程实践中,通常借助线性代数将这些计算紧密组织起来。首先,将某一层中所有神经元的激活值按列排布成一个列向量;接着,把连接这两层的所有权重整理成一个权重矩阵(Weight Matrix),矩阵中的每一行分别对应上一层所有神经元与下一层某个特定神经元之间的连接权重。如此一来,下一层神经元的所有加权求和,恰好就是该权重矩阵与激活值向量的矩阵-向量乘积(Matrix-Vector Product)。
在得到加权和向量后,再将该层的所有偏置组织为一个偏置向量并直接相加。最后,在整个括号外部套上 Sigmoid 符号 $\sigma$,表示对括号内计算出的向量中的每一个分量分别执行 Sigmoid 压缩运算。通过符号化抽象,层与层之间的复杂映射被浓缩为极其精炼的数学式:$a^{(1)} = \sigma(W a^{(0)} + b)$。这种矩阵表达不仅在概念上简洁清晰,在工程实现中更是至关重要,因为主流计算库对矩阵乘法进行了极深度的底层硬件优化,能够大幅缩减代码量并成倍提升运算速度。
- 权重矩阵的行数对应下一层神经元数量,列数对应当前层神经元数量。 - 偏置被集中表示为一个与下一层神经元数量相等的列向量。 - 外层的 Sigmoid 函数以元素级(Element-wise)方式作用于线性计算生成的向量分量。
[15:17](https://www.youtube.com/watch?v=aircAruvnKk&t=917s) 神经网络的本质:一个宏大的高维函数
虽然此前将神经元拟人化为“保存数值的容器”,但由于它们保存的具体数值完全取决于输入图像,因此更严谨的视角是将每个神经元视为一个独立的数学函数——它接收上一层所有神经元的输出,并计算吐出一个介于 0 和 1 之间的数值。推广到整体结构,整个神经网络本质上也是一个庞大而精密的复合函数:它接收代表图像像素的 784 个数值作为输入向量,经过多层矩阵乘法与非线性函数的交替迭代,最终吐出代表各类可能性的 10 个数值作为输出向量。
Grant Sanderson 强调,这种看似令人望而生畏的复杂度反而是合理的:“从某种角度来说,它看起来如此复杂反而让人感到安心。我的意思是,如果它再简单一点,我们还能抱有什么希望让它承担起识别手写数字的重任呢?”(“And in a way it's kind of reassuring that it looks complicated. I mean if it were any simpler, what hope would we have that it could take on the challenge of recognizing digits?”)正是这 13,000 个参数构成的庞大空间,赋予了网络拟合高度非线性特征的能力。
- 输入端:接收 784 维向量(对应 28×28 像素的灰度图像)。 - 输出端:输出 10 维向量(对应数字 0 到 9 的激活评分)。 - 内部机制:由 13,000 个参数参数化、通过多步矩阵变换级联而成的确定性数学映射。
[16:27](https://www.youtube.com/watch?v=aircAruvnKk&t=987s) 订阅杂谈与特别嘉宾讨论:Sigmoid 转向 ReLU
在预告下一期将深入探讨反向传播算法以及网络如何依靠数据自主学习权重偏置之后,Grant 打趣道,与其机械地喊大家点击订阅以获取推送通知,倒不如实话实说:“也许更坦白地说,我应该建议大家订阅,以便让驱动 YouTube 推荐算法的神经网络做好准备,相信你确实想看到这个频道的内容被推荐给你。”(“Maybe more honestly I should say subscribe so that the neural networks that underlie YouTube's recommendation algorithm are primed to believe that you want to see content from this channel get recommended to you.”)
随后,Grant 邀请了在深度学习理论方向取得博士学位、现就职于风投机构 Amplify Partners 的嘉宾 Lisha Li 共同探讨激活函数的演变。针对为什么现代深度学习网络不再青睐 Sigmoid 函数这一现象,两人展开了解读:
| 特性 | Sigmoid 函数 | ReLU(Rectified Linear Unit,线性整流单元) | |:--- |:--- |:--- | | **数学形式** | $\sigma(x) = \frac{1}{1 + e^{-x}}$ | $\max(0, a)$ | | **生物拟态逻辑** | 将输入压缩至 0 到 1 之间,模拟神经元处于抑制或兴奋的连续状态。 | 同样受生物学启发:未达阈值时完全不激活(输出 0),超过阈值后则呈线性响应(恒等函数)。 | | **训练表现** | 在网络层数加深时极难训练,梯度极易消失。 | 计算形式极为简化,在极深的网络架构中极易收敛,显著提升了深度网络的训练效率。 |
Lisha Li 指出,Sigmoid 函数在早期受生物学隐喻启发而被广泛使用,但在实际工程中,它让深度网络的训练变得异常困难。研究人员后来尝试使用极为简单的截断形式 $\max(0, a)$,即 ReLU 函数;当神经元未被激活时输出为 0,一旦跨过阈值便保持恒等输出。这种看似简化的激活方式在实践中取得了出人意料的卓越效果,从而在现代深度神经网络中几乎全面取代了 Sigmoid 函数。
## Notable quotes > [10:38](https://www.youtube.com/watch?v=aircAruvnKk&t=638s) 权重告诉你第二层中的这个神经元正在捕捉何种像素模式,而偏置则告诉你加权和需要达到多高,该神经元才会开始产生有意义的激活。 — Grant Sanderson
> [15:17](https://www.youtube.com/watch?v=aircAruvnKk&t=917s) 从某种角度来说,它看起来如此复杂反而让人感到安心。我的意思是,如果它再简单一点,我们还能抱有什么希望让它承担起识别手写数字的重任呢? — Grant Sanderson
## Mentioned 3Blue1Brown, Grant Sanderson, Lisha Li, Amplify Partners, Michael Nielsen, Chris Olah, Welch Labs, Ian Goodfellow, Yoshua Bengio, Aaron Courville, Distill, YouTube, manim, Vincent Rubinetti, Kevin Pluck
## Video description What are the neurons, why are there layers, and what is the math underlying it? Help fund future projects: https://www.patreon.com/3blue1brown Written/interactive form of this series: https://www.3blue1brown.com/topics/neural-networks
Additional funding for this project was provided by Amplify Partners
For those who want to learn more, I highly recommend the book by Michael Nielsen that introduces neural networks and deep learning: https://goo.gl/Zmczdy
There are two neat things about this book. First, it's available for free, so consider joining me in making a donation to Nielsen if you get something out of it. And second, it's centered around walking through some code and data, which you can download yourself, and which covers the same example that I introduced in this video. Yay for active learning! https://github.com/mnielsen/neural-networks-and-deep-learning
I also highly recommend Chris Olah's blog: http://colah.github.io/
For more videos, Welch Labs also has some great series on machine learning: https://youtu.be/i8D90DkCLhI https://youtu.be/bxe2T-V8XRs
For those of you looking to go *even* deeper, check out the text "Deep Learning" by Goodfellow, Bengio, and Courville.
Also, the publication Distill is just utterly beautiful: https://distill.pub/
Lion photo by Kevin Pluck
Звуковая дорожка на русском языке: Влад Бурмистров.
Thanks to these viewers for their contributions to translations German: @fpgro Hebrew: Omer Tuchfeld Hungarian: Máté Kaszap Italian: @teobucci, Teo Bucci
----------------- Timeline: 0:00 - Introduction example 1:07 - Series preview 2:42 - What are neurons? 3:35 - Introducing layers 5:31 - Why layers? 8:38 - Edge detection example 11:34 - Counting weights and biases 12:30 - How learning relates 13:26 - Notation and linear algebra 15:17 - Recap 16:27 - Some final words 17:03 - ReLU vs Sigmoid
Correction 14:45 - The final index on the bias vector should be "k"
------------------ Animations largely made using manim, a scrappy open source python library. https://github.com/3b1b/manim
If you want to check it out, I feel compelled to warn you that it's not the most well-documented tool, and has many other quirks you might expect in a library someone wrote with only their own use in mind.
Music by Vincent Rubinetti. Download the music on Bandcamp: https://vincerubinetti.bandcamp.com/album/the-music-of-3blue1brown
Stream the music on Spotify: https://open.spotify.com/album/1dVyjwS8FBqXhRunaG5W5u
If you want to contribute translated subtitles or to help review those that have already been made by others and need approval, you can click the gear icon in the video and go to subtitles/cc, then "add subtitles/cc". I really appreciate those who do this, as it helps make the lessons accessible to more people. ------------------
3blue1brown is a channel about animating math, in all senses of the word animate. And you know the drill with YouTube, if you want to stay posted on new videos, subscribe, and click the bell to receive notifications (if you're into that).
If you are new to this channel and want to see more, a good place to start is this playlist: http://3b1b.co/recommended
Various social media stuffs: Website: https://www.3blue1brown.com Twitter: https://twitter.com/3Blue1Brown Patreon: https://patreon.com/3blue1brown Facebook: https://www.facebook.com/3blue1brown Reddit: https://www.reddit.com/r/3Blue1Brown
[Source](https://www.youtube.com/watch?v=aircAruvnKk)